Por Igor Pacheco| Atualizado em novembro de 2026
Resposta rápida: para conciliar logs de IA e LGPD, registre por padrão os metadados que explicam o que aconteceu (identificador da requisição, versão do modelo e do prompt, tokens, latência, erros, ferramentas acionadas e documentos consultados) e deixe o texto de prompts e respostas fora do log comum. Quando o conteúdo for necessário para depurar, capture por exceção, com mascaramento na origem, armazenamento separado, acesso restrito e prazo curto de expiração.
Uma resposta errada do assistente de IA chega ao suporte. Para entender o que houve, a engenharia abre a ferramenta de observabilidade e encontra tudo: a pergunta do cliente com CPF e diagnóstico médico, os trechos de contrato que a busca recuperou, a resposta do modelo e os argumentos enviados para a API de pagamentos. O problema é resolvido em minutos, mas o registro com tudo isso continua lá, acessível a dezenas de pessoas, sem data para sair.
Essa é a tensão entre logs de IA e LGPD. Sem registro, não há como investigar alucinações, falhas de ferramentas ou tentativas de prompt injection. Com registro demais, o log vira uma cópia paralela das conversas, fora do mapa de dados e com controles mais fracos que os do sistema principal.
Este blog vai tratar dos logs técnicos da aplicação, usados por engenharia e segurança, e mostrar o que registrar, como reduzir o conteúdo de prompts e respostas, onde mascarar, quem deve acessar e por quanto tempo guardar.
Por que logs de IA viram um risco de privacidade?
Viram risco porque, em aplicações com modelos de linguagem, o conteúdo da requisição é a própria entrada do usuário. Em um sistema tradicional, o log registra que um endpoint respondeu com erro 500. Em uma aplicação com IA, a chamada ao modelo carrega o texto livre digitado pela pessoa, o prompt de sistema, os documentos recuperados e os resultados das ferramentas. Se o log captura a requisição inteira, captura tudo isso.
Os dados pessoais em logs também se espalham mais que os do banco de produção. O mesmo evento pode seguir para a plataforma de monitoramento, o SIEM, o data lake e a ferramenta de avaliação de um fornecedor, cada um com seus administradores e sua retenção padrão. Para a LGPD, armazenar é tratamento (art. 5º, X), e o princípio da necessidade (art. 6º, III) limita o tratamento ao mínimo necessário para a finalidade. O log de depuração precisa caber nessa conta, como qualquer outro uso de dados em projetos de inteligência artificial e LGPD.
O risco já aparece nos referenciais de segurança e nos incidentes. Na edição 2025 do OWASP Top 10 para aplicações com LLM, a divulgação de informações sensíveis subiu da sexta para a segunda posição. Em janeiro de 2025, a Wiz Research encontrou um banco de dados da DeepSeek aberto na internet, sem autenticação, com mais de um milhão de linhas de log que incluíam histórico de conversas em texto puro e chaves de API.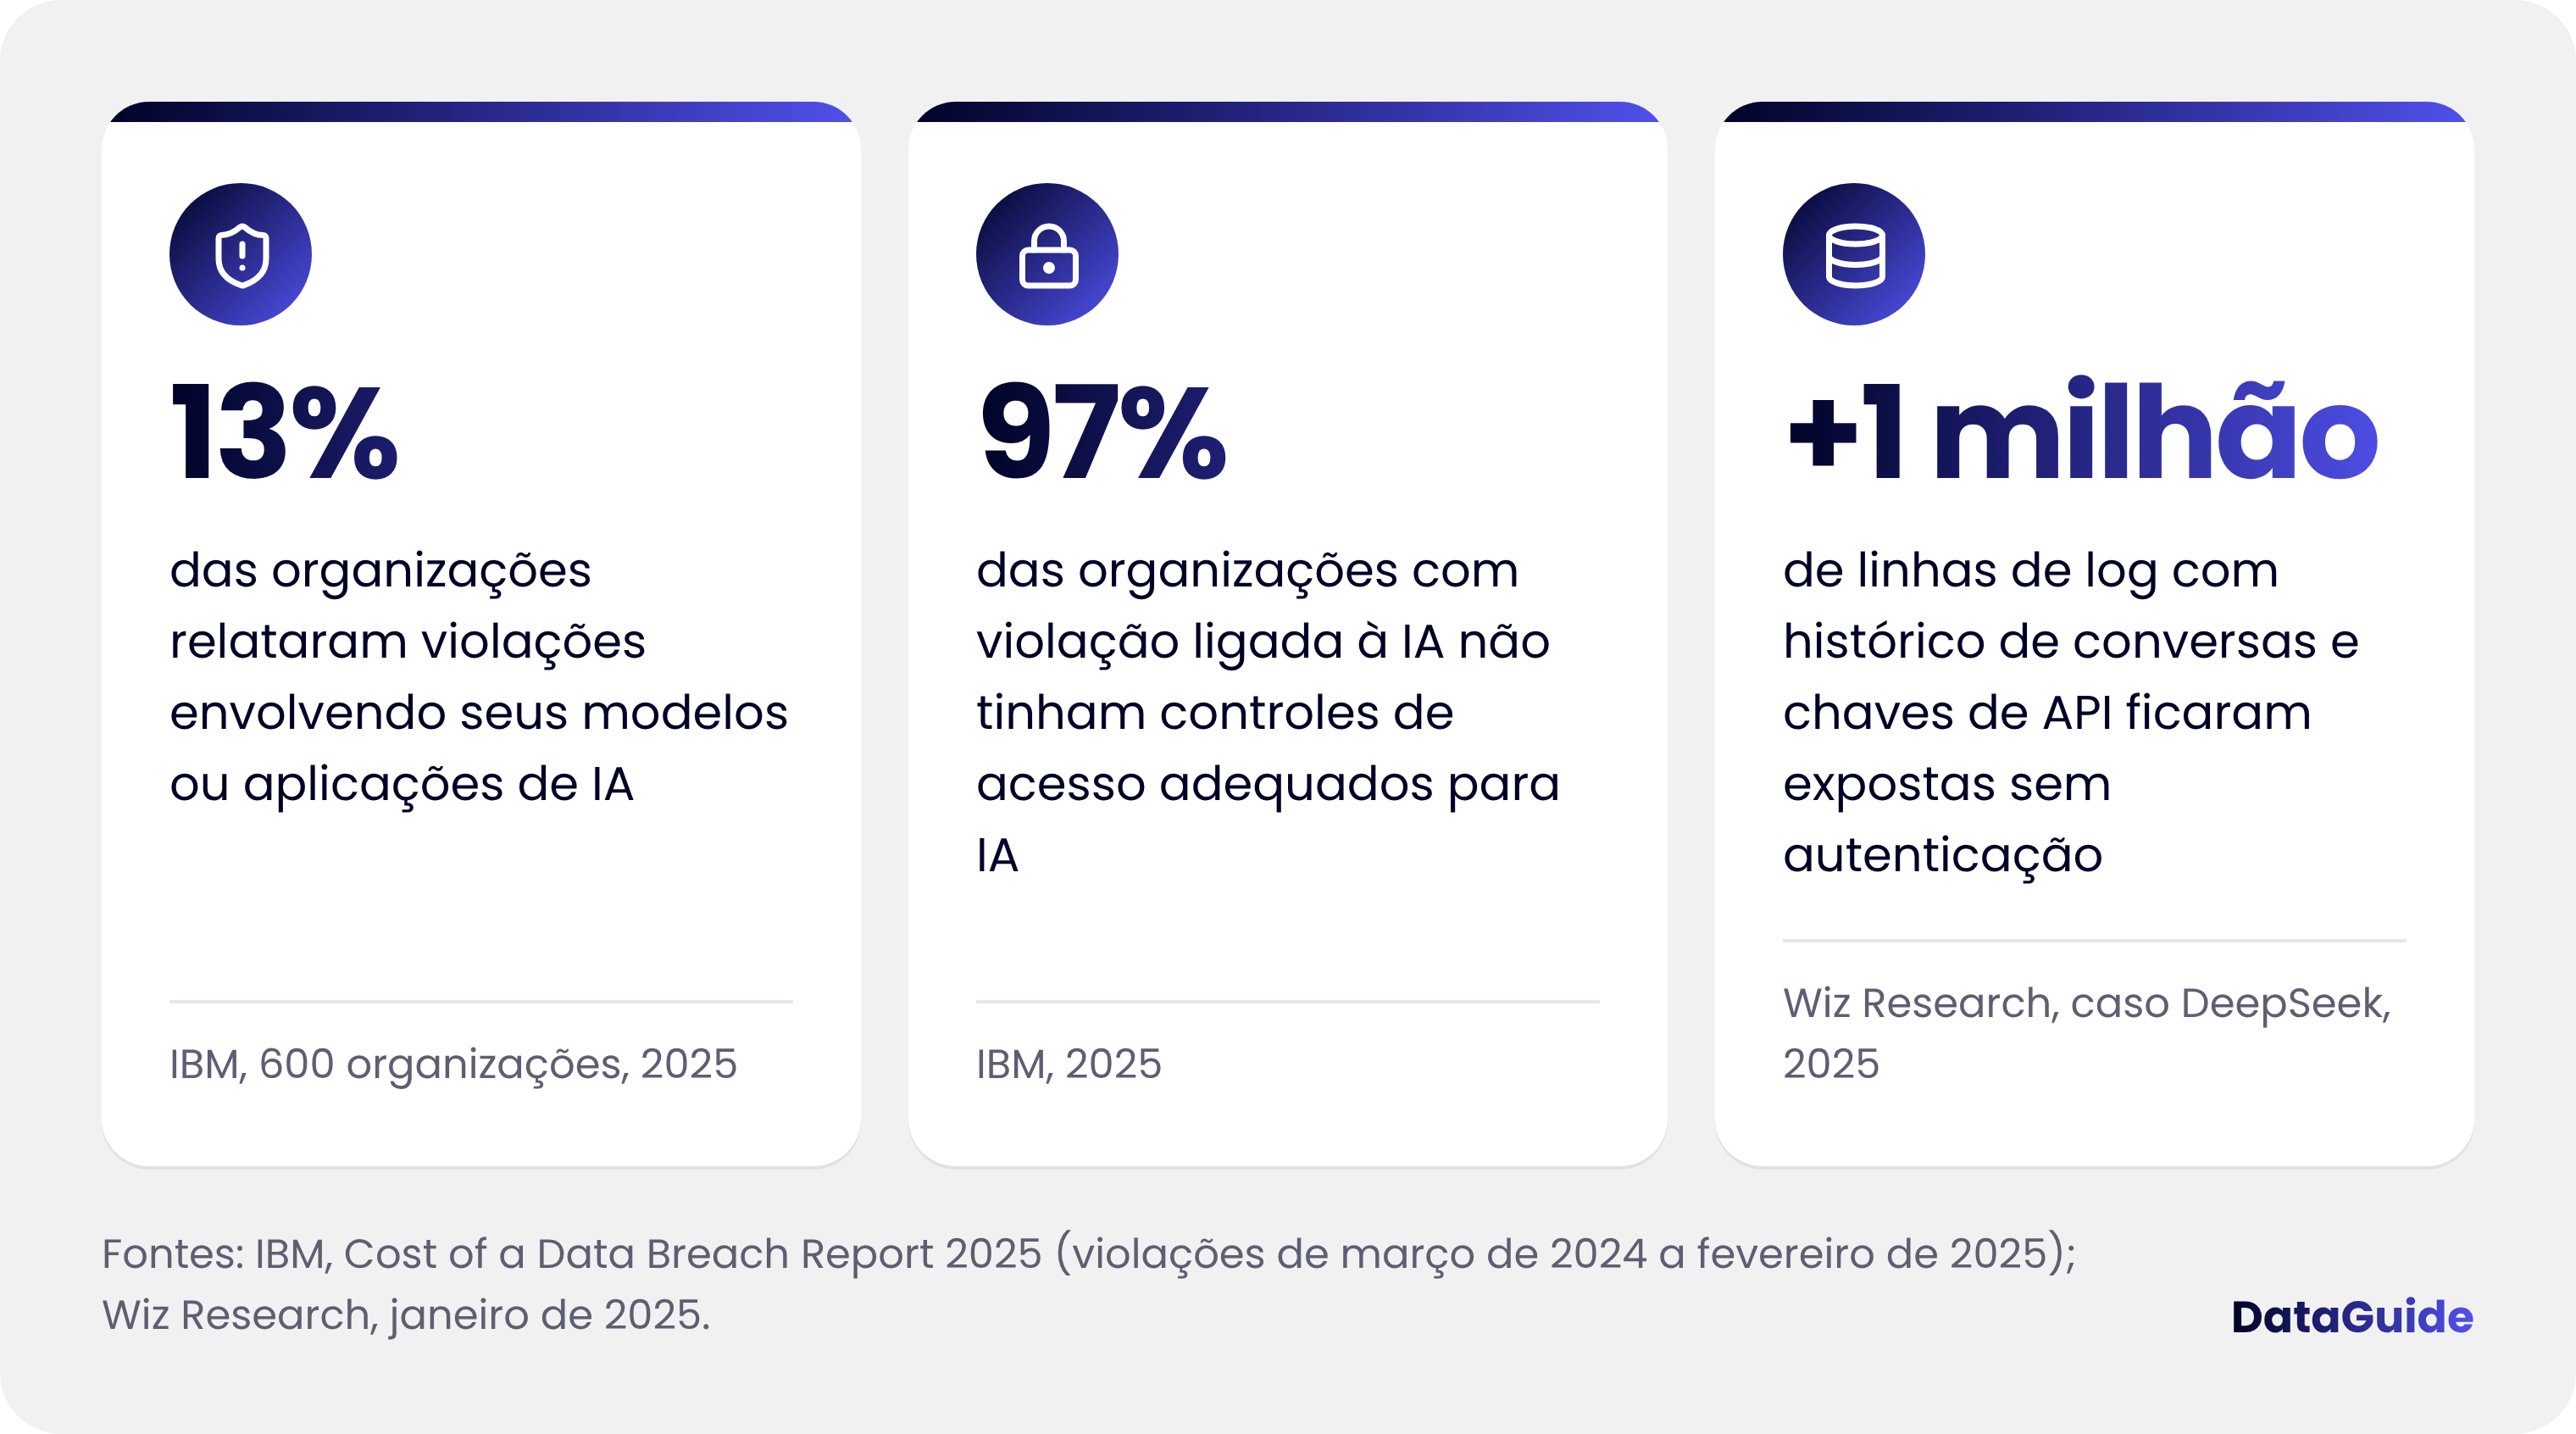 Figura 1. Violações envolvendo IA ainda são minoria, mas quase todas aconteceram sem controle de acesso adequado, e logs com conteúdo de conversas já apareceram expostos.
Texto alternativo: Três cartões sobre logs de IA e LGPD: 13% das organizações relataram violações de modelos ou aplicações de IA (IBM, 2025); 97% delas não tinham controles de acesso adequados para IA (IBM, 2025); mais de um milhão de linhas de log com conversas e chaves de API ficaram expostas no caso DeepSeek (Wiz Research, 2025).
Telemetria útil versus repositório de conversas
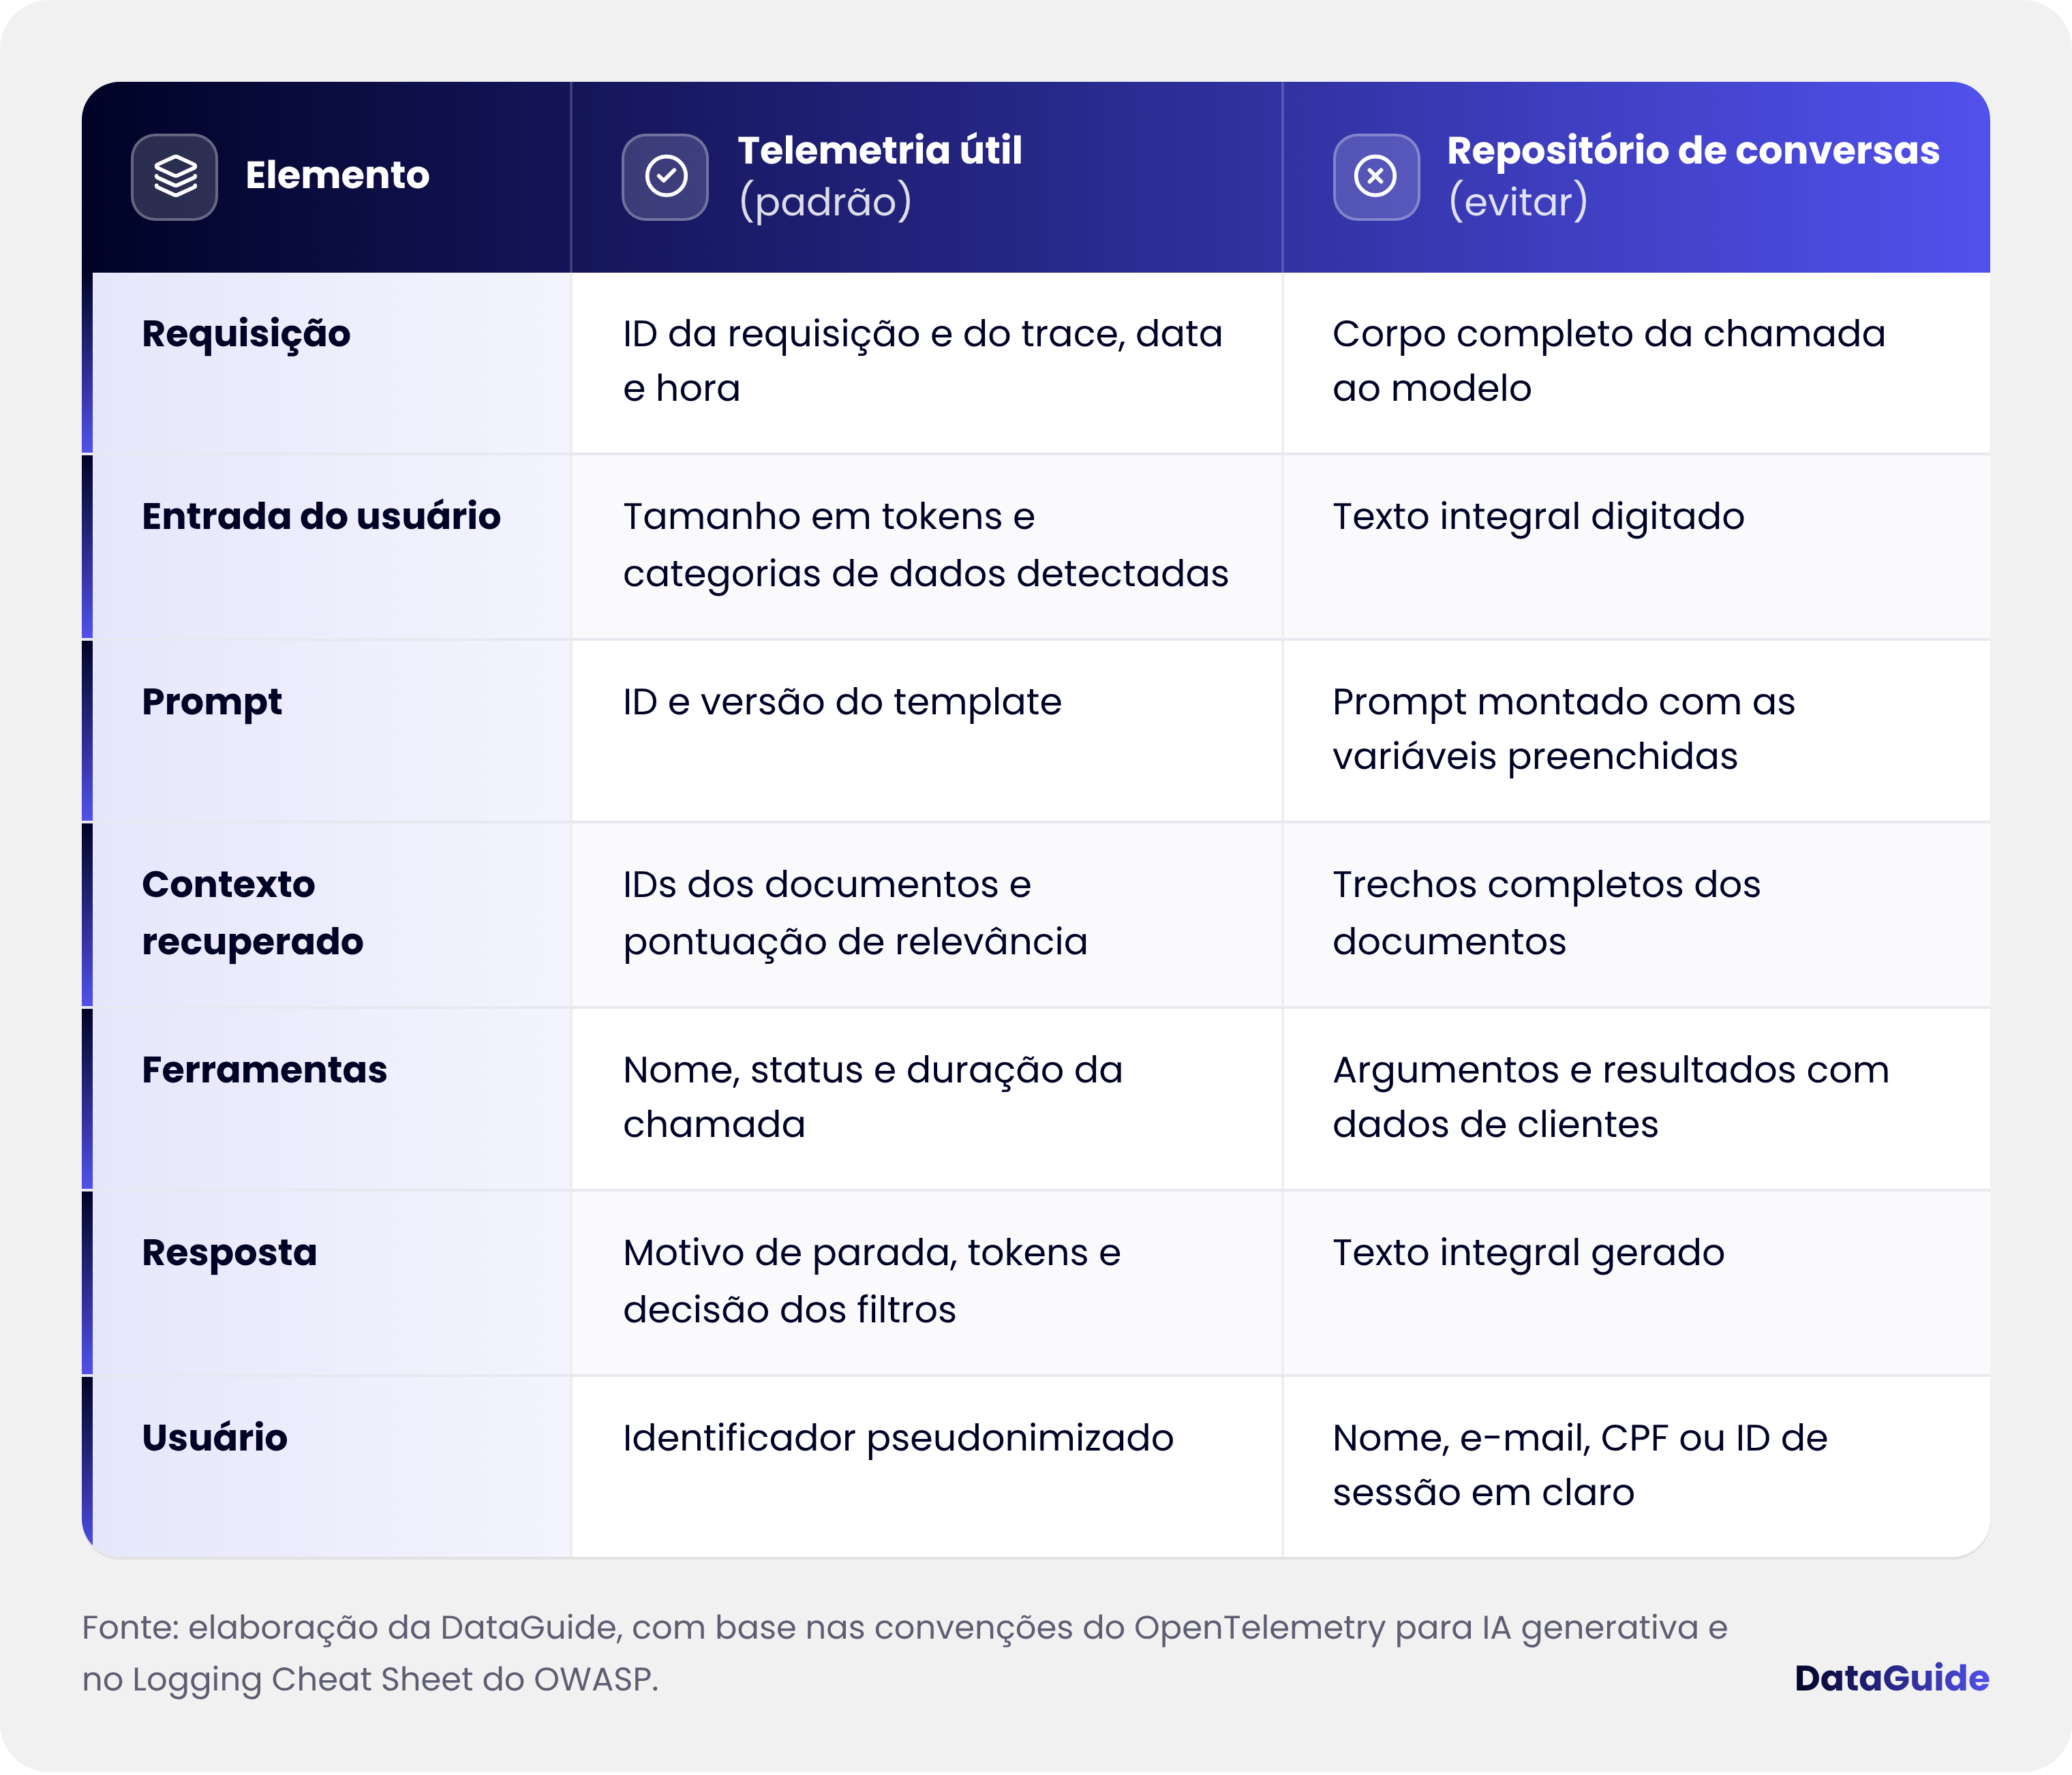
Telemetria útil é o conjunto de sinais que permite reconstruir o que a aplicação fez sem reproduzir o que o usuário disse. Repositório de conversas é o log que guarda prompts e respostas completos por padrão, de todos os usuários, para o caso de um dia ser preciso. A primeira atende à observabilidade de IA, já o segundo cria uma base de dados pessoais que ninguém decidiu criar.
Na maioria das investigações, os metadados respondem às perguntas certas: qual versão do modelo respondeu, qual versão do prompt estava em uso, quanto tempo levou, quantos tokens consumiu, por que a geração parou, qual ferramenta foi chamada e com qual resultado. Em aplicações que buscam em bases internas, registrar os identificadores dos documentos recuperados, sem o texto, também ajuda a auditar falhas de permissão, tema que detalhamos no artigo sobre segurança em RAG.
As convenções semânticas do OpenTelemetry para IA generativa, ainda em desenvolvimento, seguem essa lógica. Atributos como modelo, tokens e tipo de erro são recomendados. O histórico de mensagens enviado ao modelo é opcional, de ativação explícita, com o aviso de que provavelmente contém dados pessoais.
Minimização de prompts e respostas nos logs
Minimização de prompts é registrar só a parte do conteúdo que a investigação exige, pelo tempo que ela exige. Na prática, o texto integral deixa de ser o padrão e passa a ser uma exceção controlada.
O OWASP segue nessa direção. O guia de prevenção de prompt injection recomenda registrar metadados e decisões relevantes para a segurança, excluindo credenciais, segredos e conteúdo sensível desnecessário de prompts e respostas. O monitoramento continua, no entanto, o que vai para o registro muda.
Em avaliações de produtos com IA, a equipe da DataGuide encontra com frequência o mesmo cenário: a captura de conteúdo ligada durante o piloto continua ligada à produção, sem que ninguém tenha decidido isso. Quatro técnicas resolvem a maior parte dos casos:
Registrar o template, não o prompt montado. O identificador e a versão do prompt de sistema bastam para reproduzir o comportamento em teste.
Trocar valores por contagens e categorias. "A entrada continha 1 CPF e 1 e-mail" ajuda a investigar sem guardar os dados.
Usar hash para agrupar repetições. Um hash do texto normalizado mostra que a mesma pergunta gerou 300 erros, sem revelar a pergunta.
Capturar conteúdo por exceção. Só em erros, em uma amostra pequena ou em uma janela de depuração aberta por um responsável, com data para fechar.
Na prática: trate o modo de depuração como um acesso privilegiado. Alguém pede, alguém aprova, ele vale para um escopo definido (um cliente, um fluxo, algumas horas) e expira sozinho. O conteúdo capturado vai para um armazenamento separado, com prazo de dias, e não de meses.
Mascaramento e separação de ambientes
Mascaramento de logs é a substituição de dados pessoais e segredos por marcadores, valores parciais ou pseudônimos antes de o registro ser gravado. O Logging Cheat Sheet do OWASP lista o que normalmente não deve ir direto ao log, como identificadores de sessão, tokens de acesso, senhas, chaves e dados pessoais sensíveis, e orienta remover, mascarar, sanitizar, aplicar hash ou criptografar esses valores.
O ponto de aplicação faz diferença. Mascarar na origem, dentro da aplicação e antes do envio ao SDK de observabilidade, impede que o dado saia. Mascarar no coletor funciona como segunda camada. Mascarar só na tela de consulta deixa o dado íntegro no armazenamento e nas cópias.
As ferramentas de observabilidade de IA mais usadas oferecem esse controle na origem, mas o padrão varia. Nas instrumentações de IA generativa do OpenTelemetry, a captura do conteúdo das mensagens vem desligada e só é ativada pela variável OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT. Já o OpenLLMetry, da Traceloop, grava prompts e respostas por padrão e deixa de gravar com TRACELOOP_TRACE_CONTENT=false. No LangSmith, plataforma de traces do ecossistema LangChain, as variáveis LANGSMITH_HIDE_INPUTS e LANGSMITH_HIDE_OUTPUTS ocultam entradas e saídas, e a função create_anonymizer mascara apenas os campos escolhidos. O Langfuse aplica uma função de mascaramento definida pela equipe antes de os dados saírem da aplicação, e o Arize Phoenix permite ocultar entradas e saídas por configuração. Vale conferir essas opções em cada ambiente antes do lançamento.
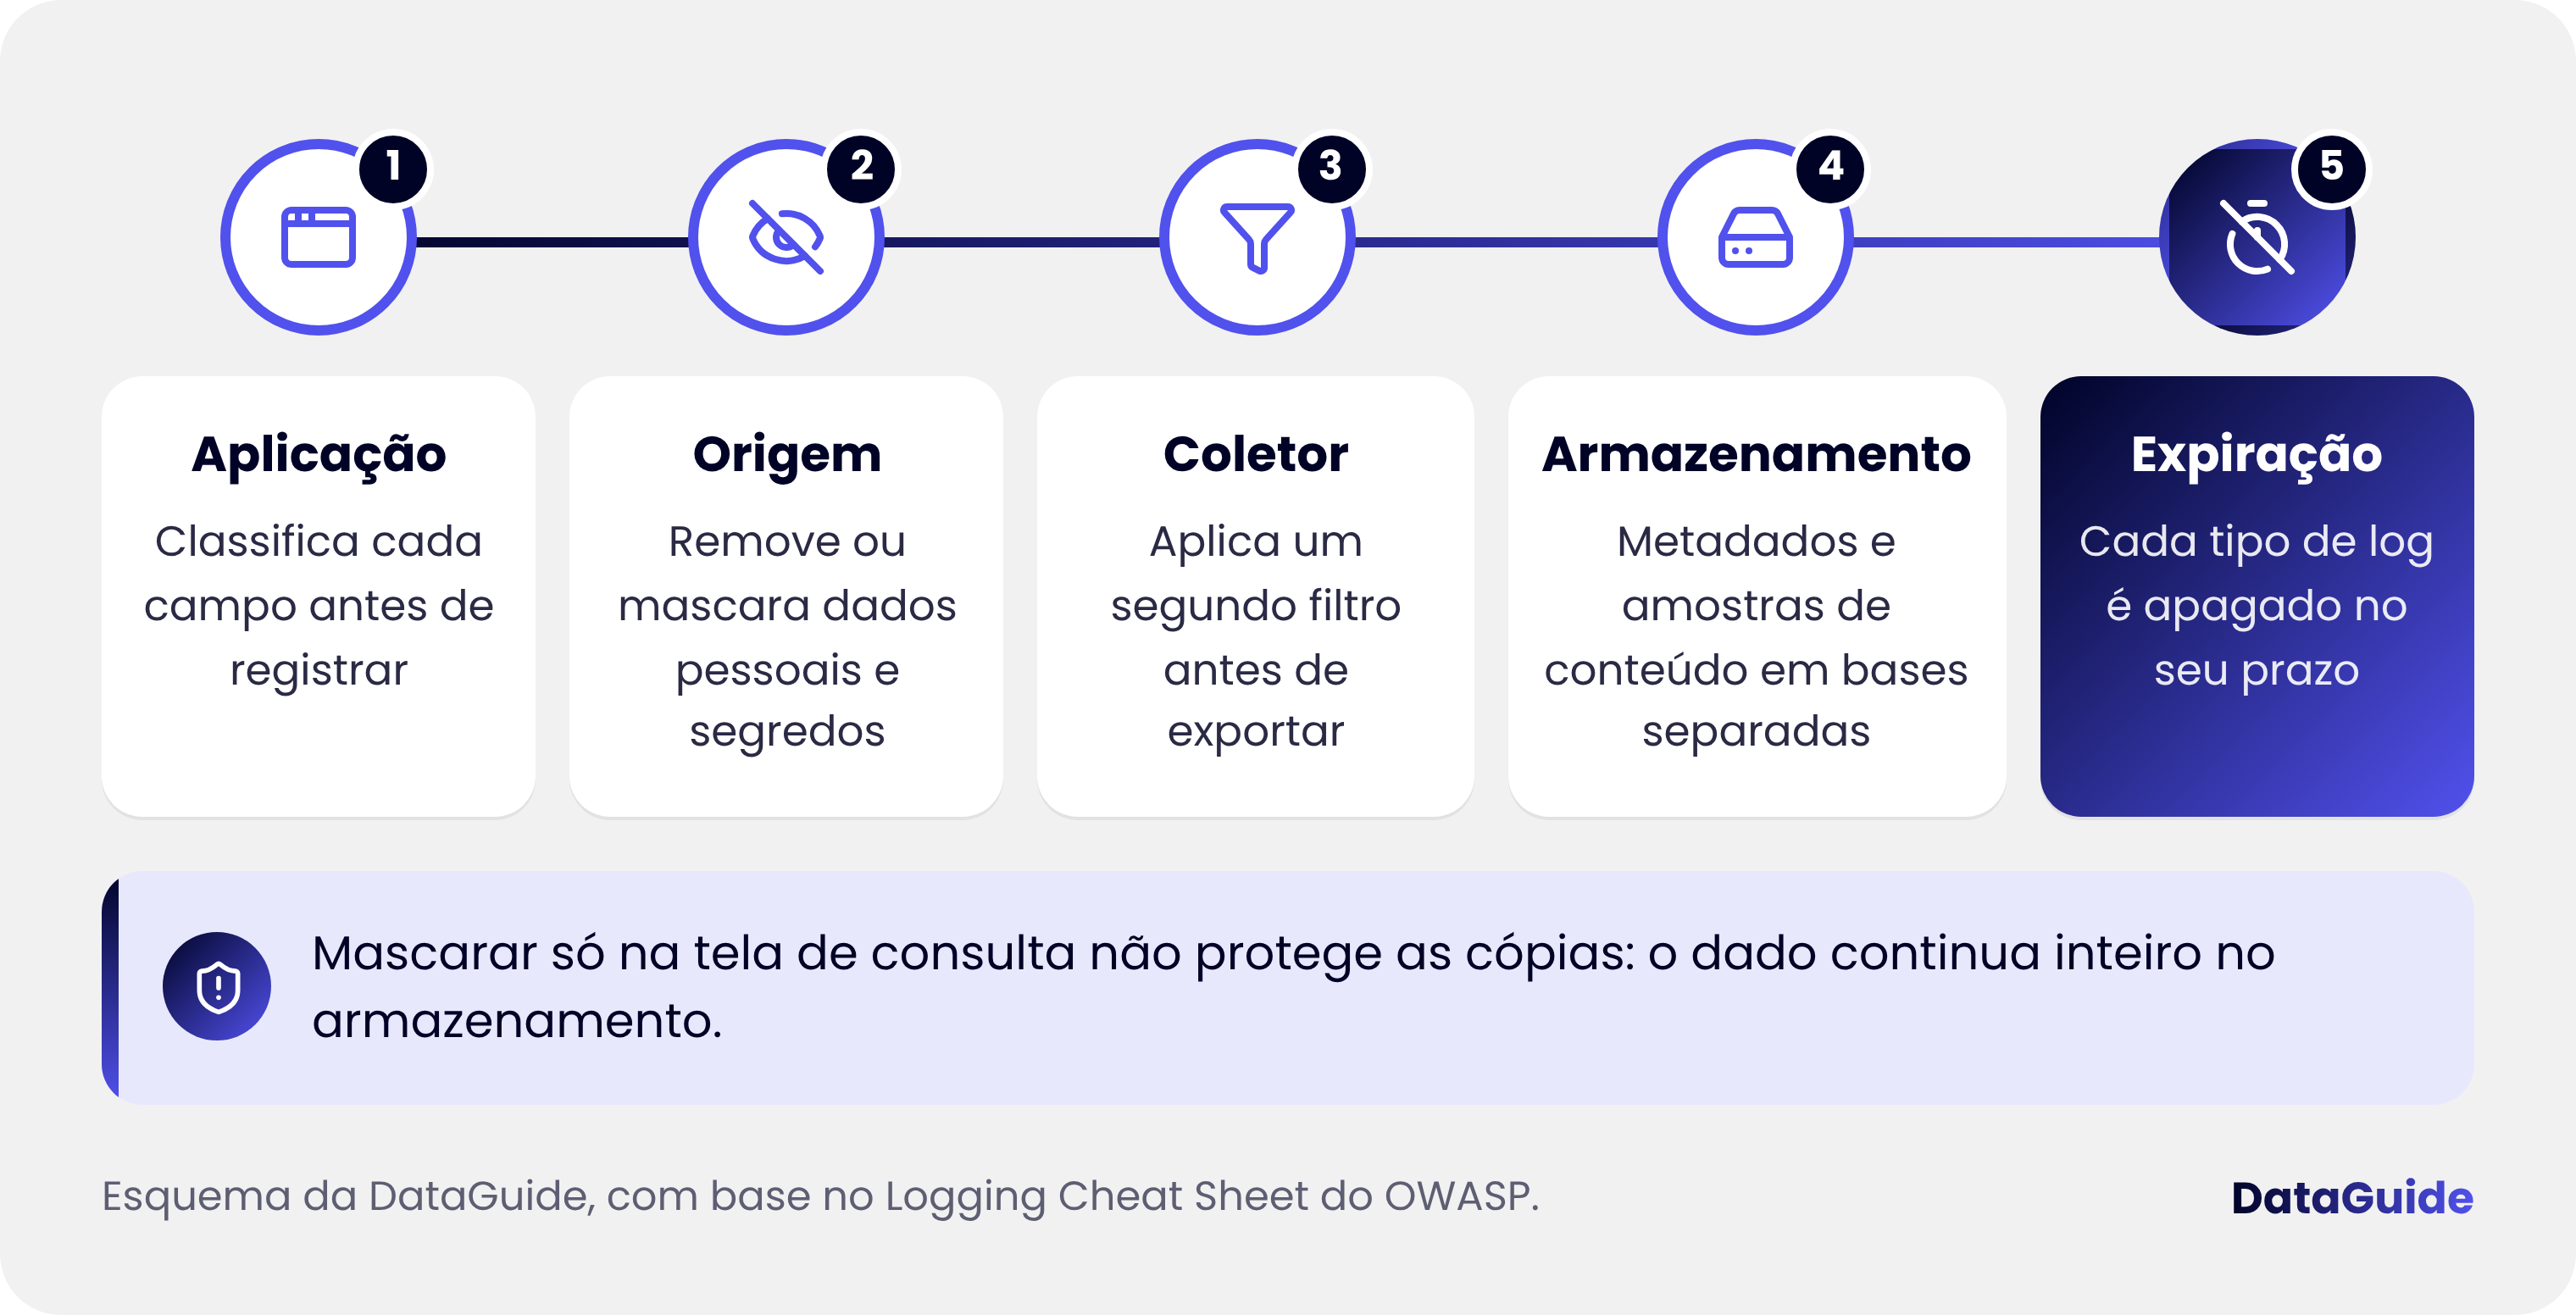 Figura 2. O mascaramento funciona melhor na origem, com o coletor como segunda camada, e termina com a expiração automática de cada tipo de registro.
Texto alternativo: Fluxo de mascaramento de logs em cinco etapas: a aplicação classifica os campos, a origem remove ou mascara dados pessoais e segredos, o coletor aplica um segundo filtro, o armazenamento separa metadados de amostras de conteúdo e cada tipo de log expira no seu prazo.
Detectores por padrão funcionam bem para CPF, e-mail, telefone, cartão e chaves de API. Nomes, endereços por extenso e relatos de saúde em texto livre escapam com facilidade, por isso o mascaramento precisa de testes com exemplos do seu domínio e de revisão periódica das falhas. Bibliotecas de código aberto, como o Microsoft Presidio, combinam reconhecimento de entidades (NER) e expressões regulares, e permitem criar reconhecedores próprios, por exemplo, para o CPF. No entanto, também precisam passar por testes antes de serem adotadas. Para identificadores com poucas combinações possíveis, como o CPF, um hash simples pode ser revertido por tentativa e erro; prefira hash com chave secreta (HMAC) ou tokenização.
A separação de ambientes completa o controle. Dados de produção não devem aparecer em logs de desenvolvimento e homologação. A captura de conteúdo, por sua vez, pode ficar ligada nesses ambientes, desde que eles usem dados sintéticos. Conjuntos de avaliação montados a partir de logs de produção seguem as mesmas regras de mascaramento e prazo.
Acesso, retenção e rastreabilidade
A retenção de logs deve ser definida por tipo de registro, de acordo com a finalidade de cada um. O OWASP resume a regra: logs não devem ser destruídos antes do período exigido nem mantidos além dele. Métricas agregadas podem durar mais; amostras de conteúdo, o mínimo possível.
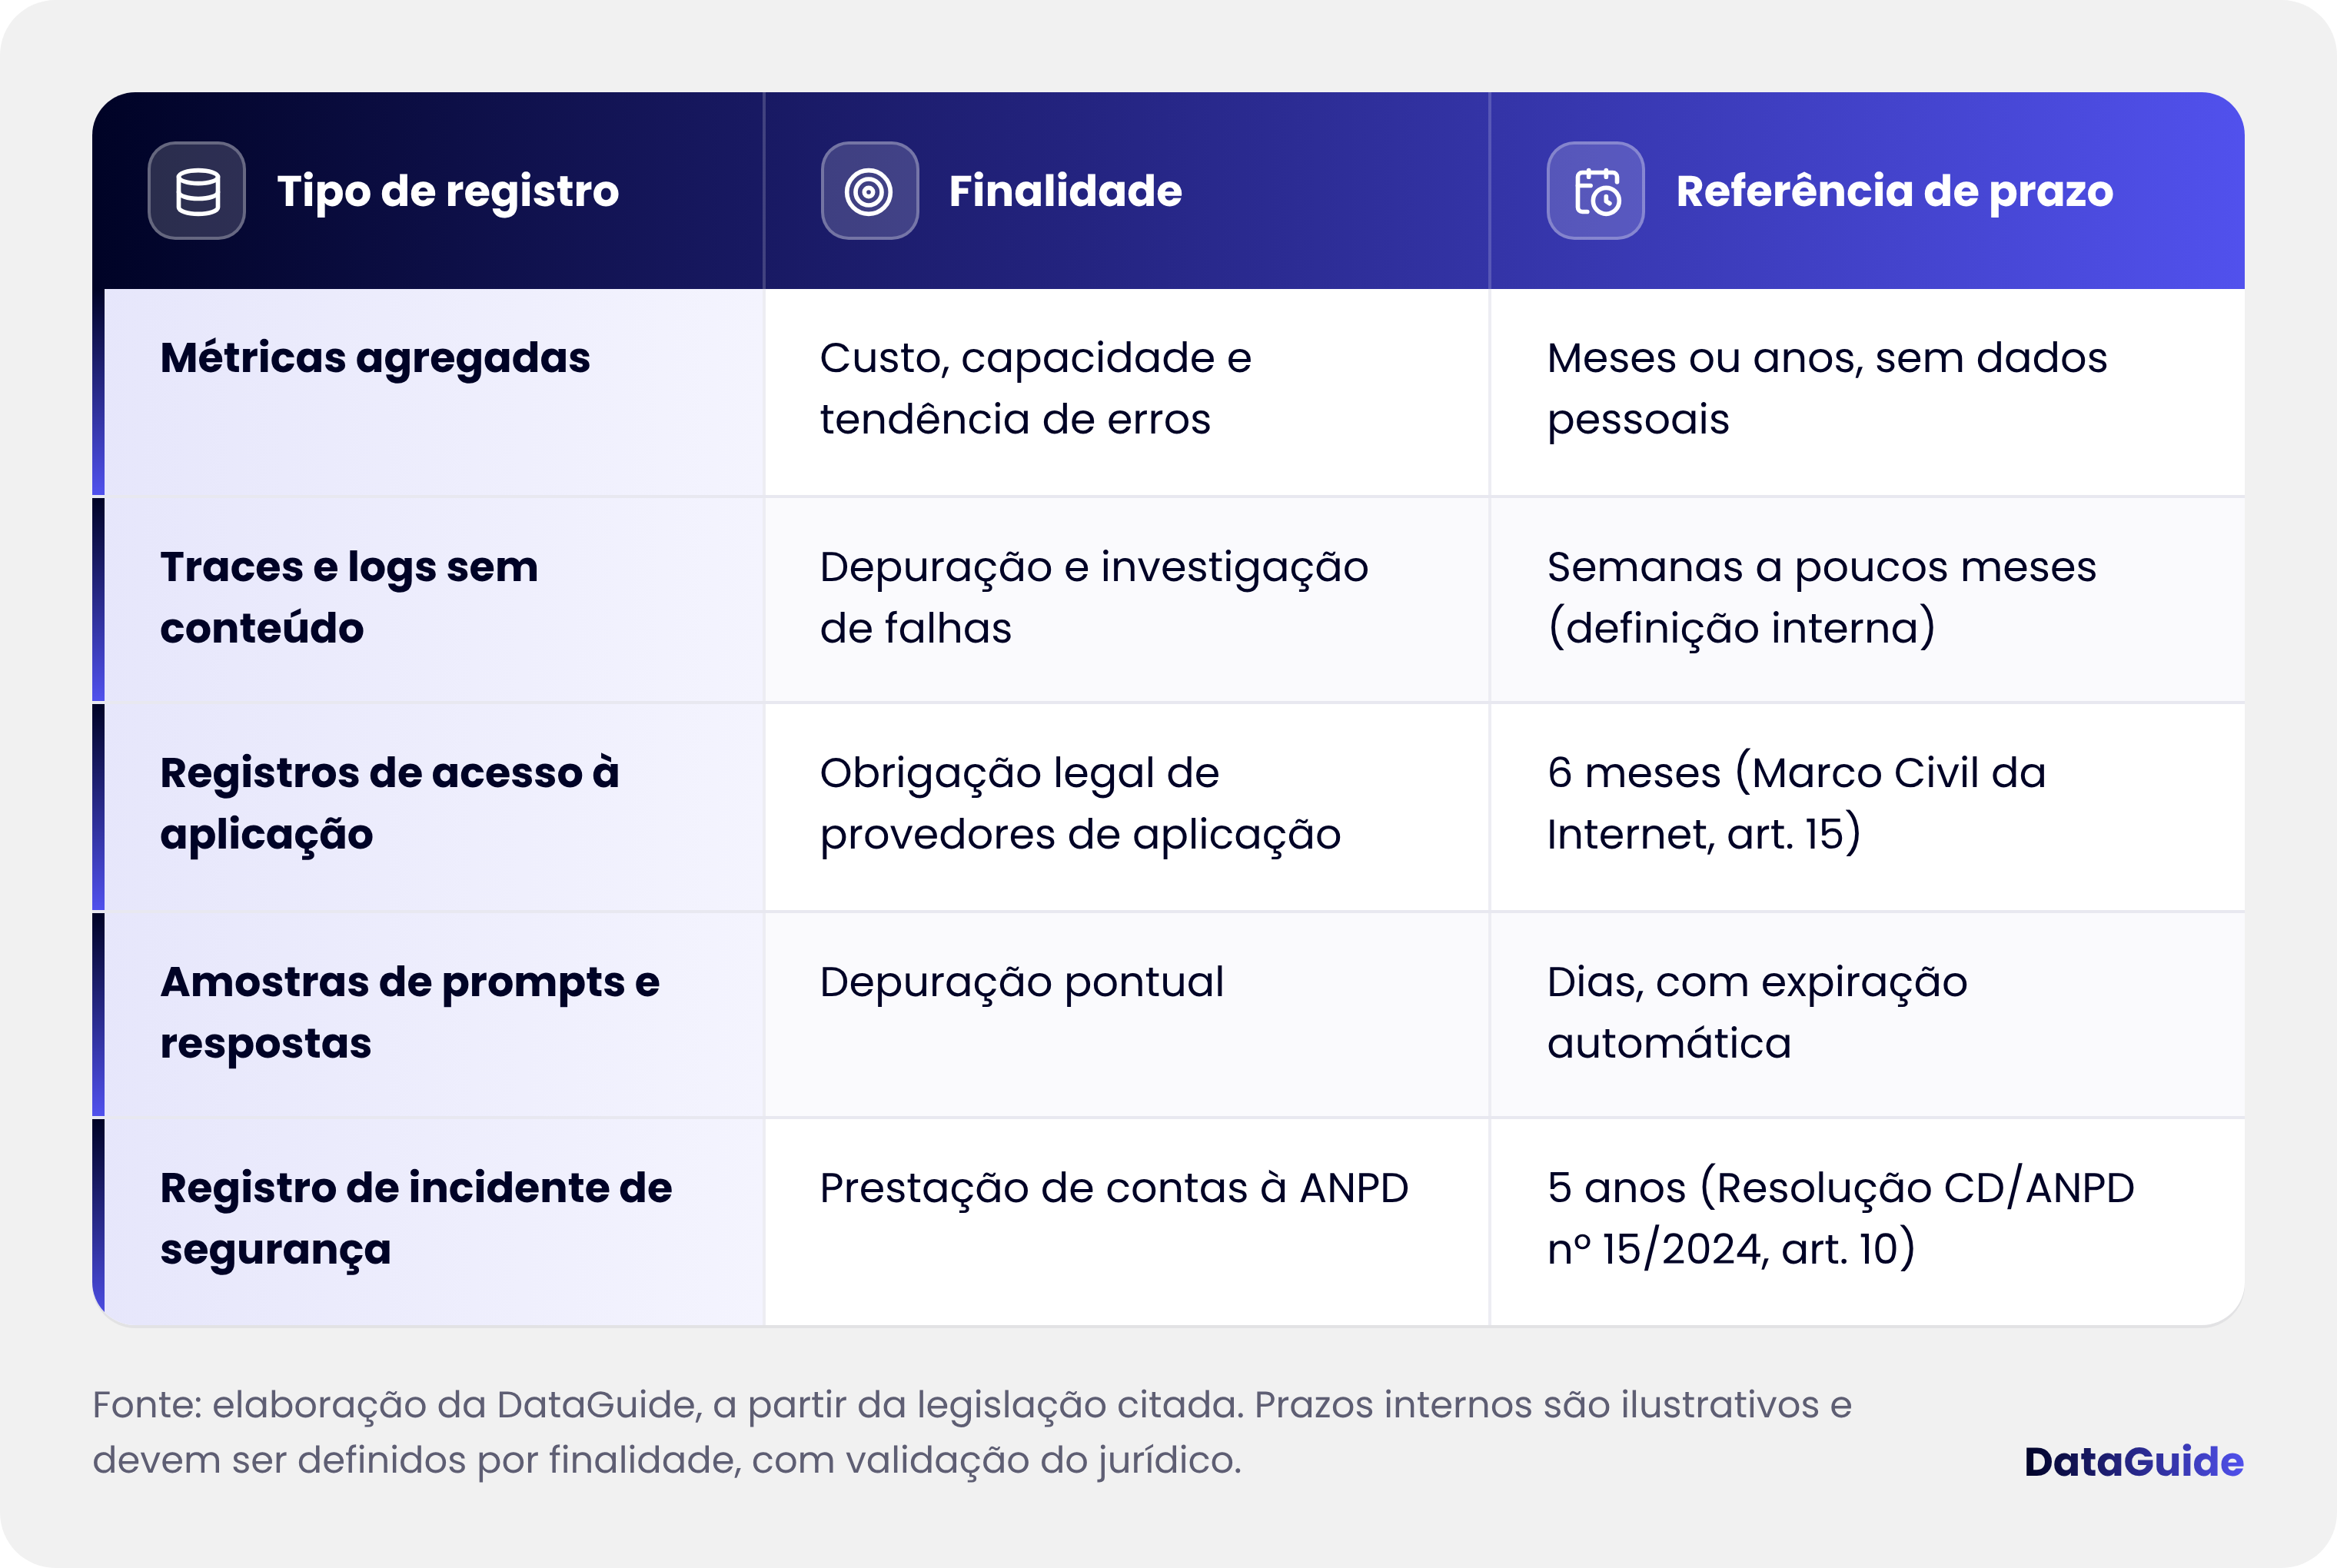
Dois cuidados na leitura da tabela: o primeiro é o prazo do Marco Civil vale para registros de acesso, que a lei define como data e hora de uso de uma aplicação a partir de um endereço IP, e não justifica guardar o conteúdo das conversas; o segundo é o registro de incidente exigido pela ANPD é um documento sobre o incidente: ele referencia as evidências preservadas, sem exigir que todos os logs brutos fiquem cinco anos.
O acesso segue o mesmo raciocínio. Metadados podem ficar disponíveis para engenharia e operação; amostras de conteúdo, só para um grupo pequeno, com justificativa. Toda consulta aos logs deve ser registrada e monitorada, como recomenda o OWASP, e os privilégios revistos periodicamente.
Rastreabilidade de IA é a capacidade de reconstruir, a partir de um identificador, o caminho de uma resposta: requisição, versão do modelo, versão do prompt, documentos recuperados, ferramentas chamadas, decisões dos filtros e resultado. Ela depende de um ID propagado entre os serviços e de registros protegidos contra alteração. Bem desenhada, permite investigar sem guardar a conversa e sustenta a resposta a incidentes nas primeiras horas, quando ainda não se sabe o tamanho do problema.
Perguntas para responder antes do lançamento
Decisões sobre logs saem mais baratas antes de o produto entrar em produção. Depois, o conteúdo já se espalhou por ferramentas, cópias e fornecedores. As perguntas abaixo servem de roteiro para engenharia, segurança e privacidade revisarem juntas a rastreabilidade de IA do produto.
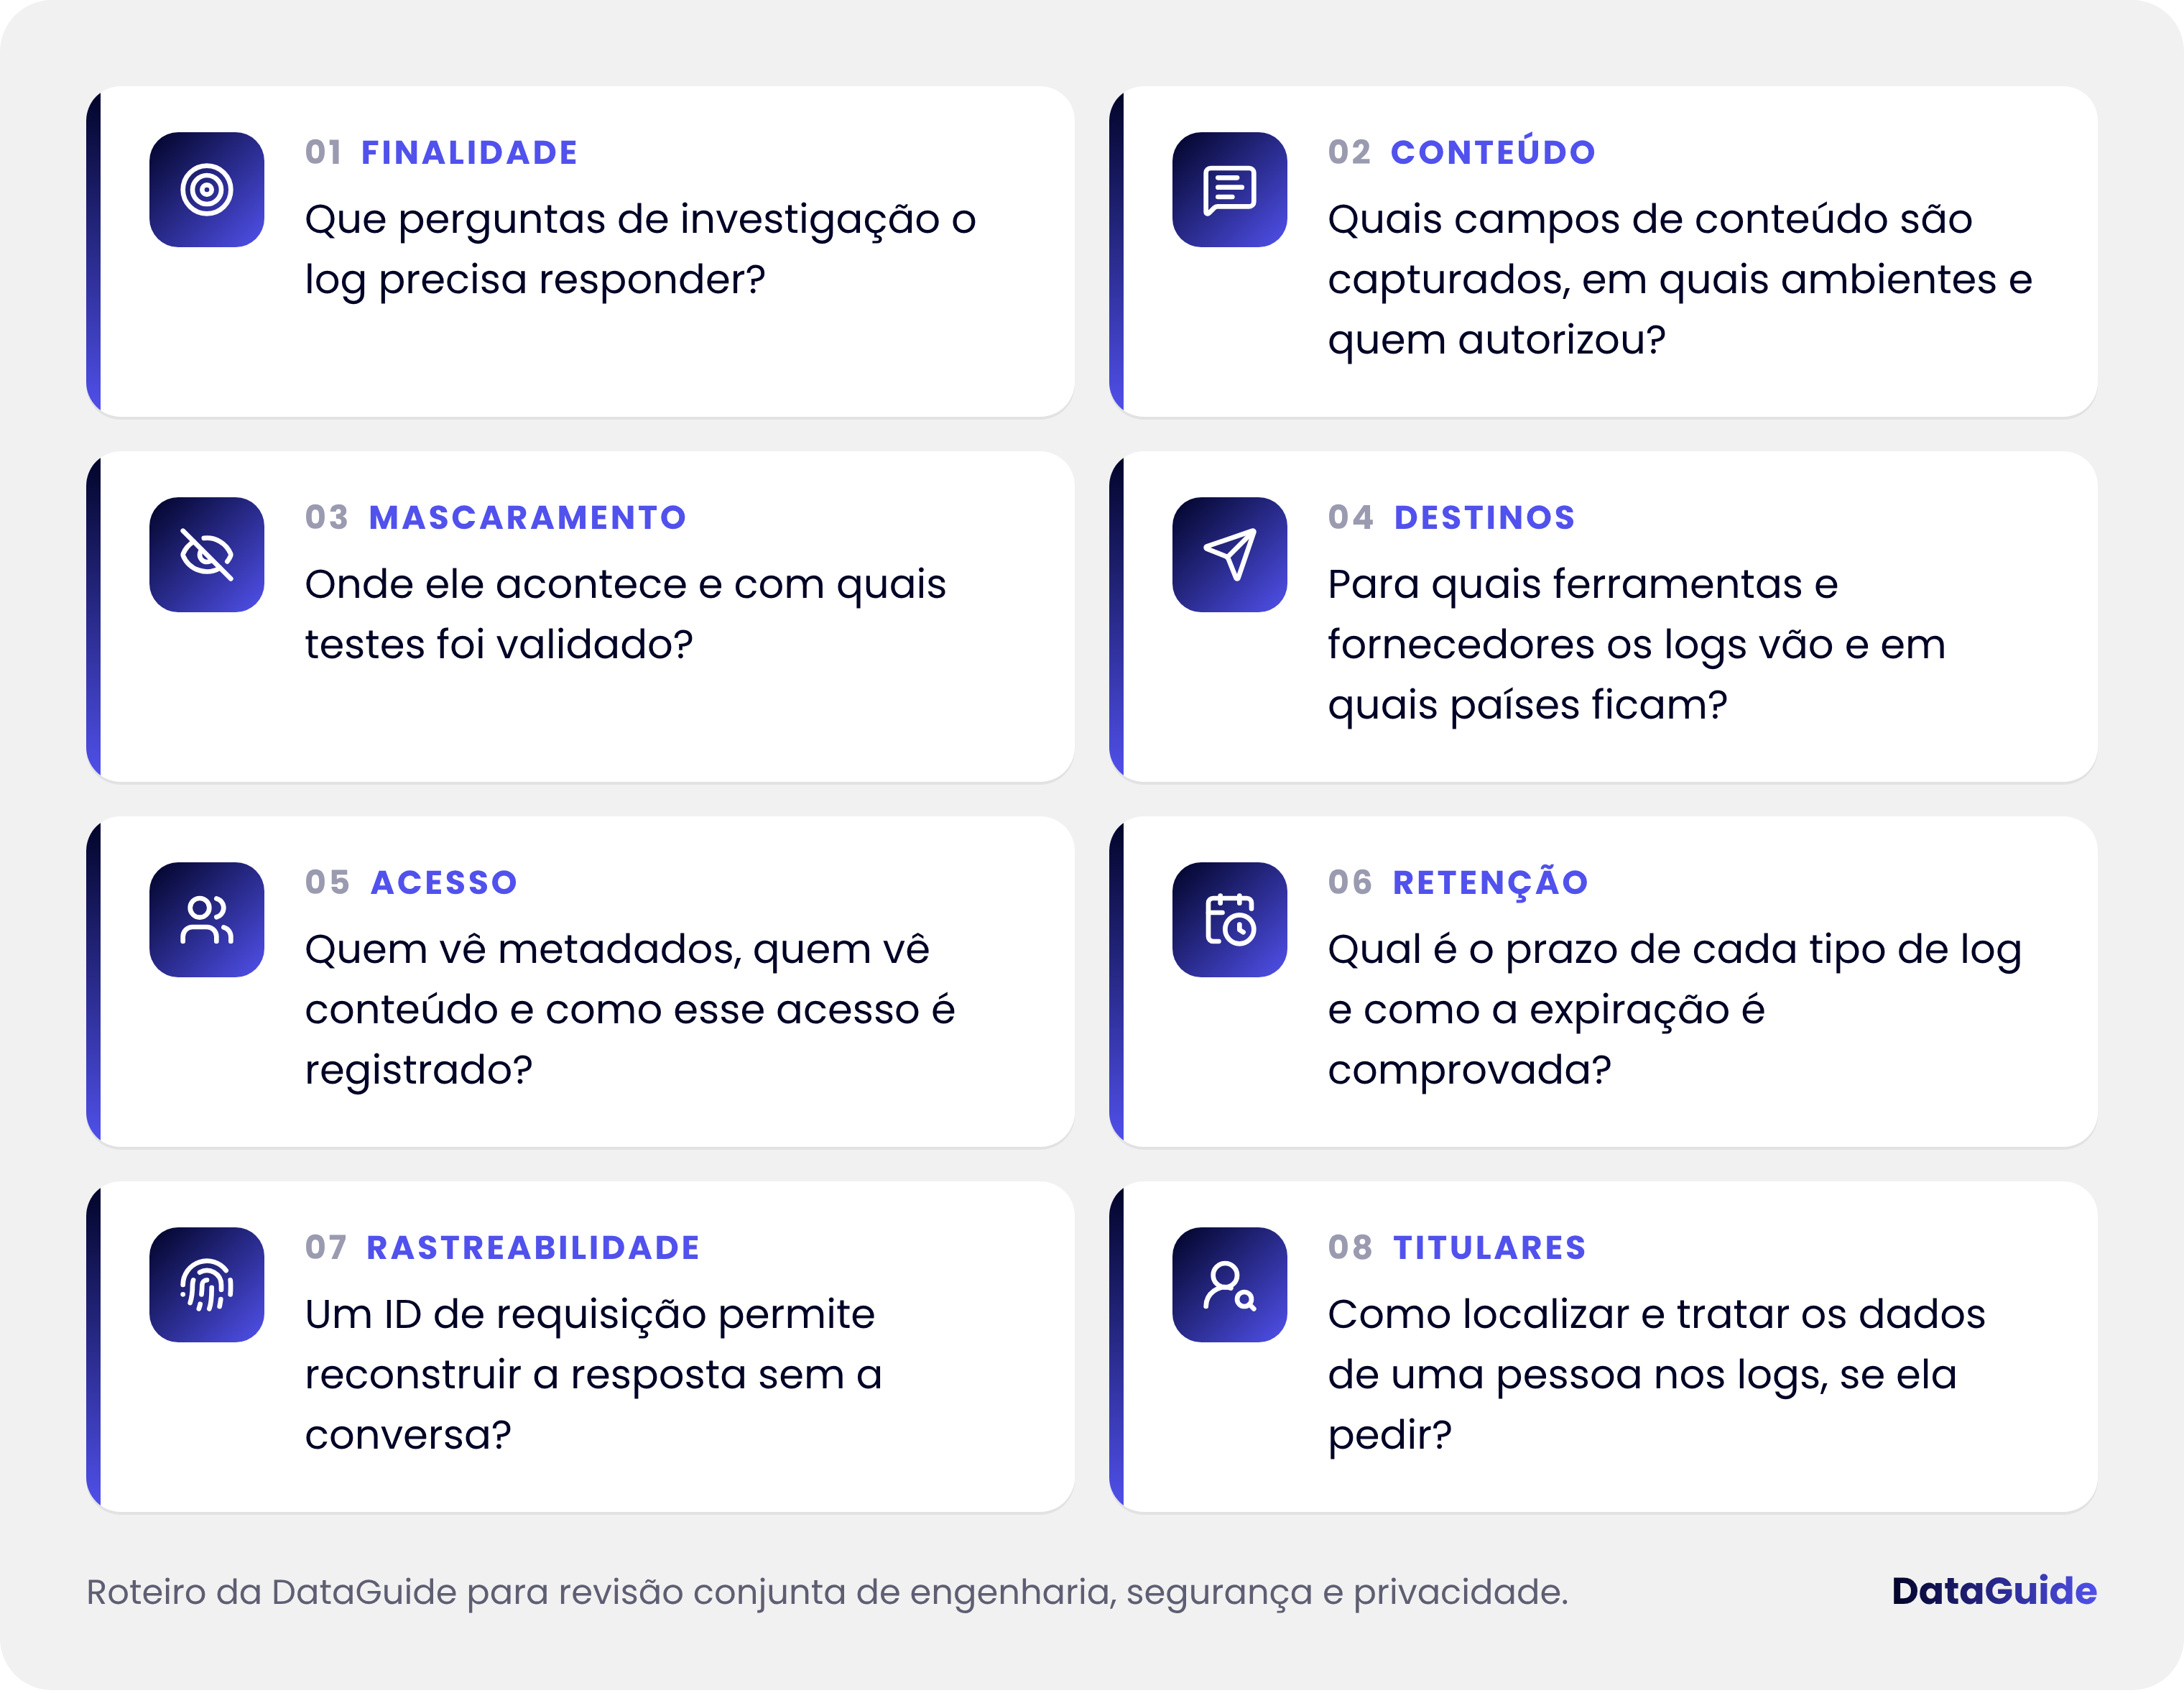
Figura 3. Respostas claras a estas oito perguntas mostram se o produto consegue investigar falhas sem acumular dados pessoais em logs.
Texto alternativo: Checklist de rastreabilidade de IA com oito perguntas antes do lançamento: finalidade do log, conteúdo capturado, mascaramento, destinos e países, acesso, retenção, rastreabilidade por ID de requisição e atendimento a titulares.
As respostas devem entrar na documentação de privacidade. O log é uma operação de tratamento e aparece no registro exigido pelo art. 37 da LGPD. Quando o produto trata dados sensíveis ou grande volume de dados, a análise também cabe no relatório de impacto, como mostramos no RIPD passo a passo. Inclua os fornecedores de observabilidade e o provedor do modelo, que podem manter cópias das requisições por prazos próprios, definidos em contrato.
Conclusão
Logs de IA e LGPD convivem bem quando o log é desenhado para responder perguntas de investigação, e não para guardar tudo por precaução. Metadados por padrão, conteúdo por exceção, mascaramento na origem, ambientes separados, acesso registrado e prazos por tipo de registro resolvem a maior parte do conflito entre observabilidade e privacidade.
Essas escolhas fazem parte da governança do sistema de IA como um todo. Quem está estruturando essa governança encontra na ISO 42001 um modelo para documentar controles, responsabilidades e registros ao longo do ciclo de vida da IA.
Fica um teste para a sua equipe: se alguém pedir hoje todos os logs que mencionam um cliente específico, quantos sistemas vocês precisariam consultar?
Revise os logs do seu produto de IA antes do próximo incidente. A DataGuide ajuda a mapear o que sua aplicação registra, testar os controles com pentest e análise de vulnerabilidades e alinhar a operação às normas ISO 27001 e ISO 27701. Conheça as nossas soluções de segurança da informação.
Fontes
Lei 13.709/2018 (LGPD): Lei Geral de Proteção de Dados, texto oficial no Planalto
Marco Civil da Internet: Lei 12.965/2014, texto oficial no Planalto
ANPD: Resolução CD/ANPD nº 15/2024, Regulamento de Comunicação de Incidente de Segurança
OWASP: Top 10 for LLM Applications 2025, LLM02: Sensitive Information Disclosure
OWASP: Logging Cheat Sheet (dados a excluir, retenção e acesso aos logs)
OWASP: LLM Prompt Injection Prevention Cheat Sheet (monitoramento e registro)
OpenTelemetry: Convenções semânticas para spans de IA generativa
OpenTelemetry: Instrumentação de IA generativa para Python (captura de conteúdo das mensagens)
Traceloop: OpenLLMetry, privacidade de prompts, respostas e embeddings
LangChain: LangSmith, como evitar o registro de dados sensíveis em traces
Microsoft: Presidio, detecção e anonimização de dados pessoais
IBM: Cost of a Data Breach Report 2025: violações envolvendo IA e controles de acesso
Wiz Research: Banco de dados exposto da DeepSeek com histórico de conversas e chaves de API (janeiro de 2025)
Perguntas Frequentes
Posso guardar prompts e respostas completos nos logs?
Pode, se houver finalidade definida e controles proporcionais, mas não como padrão para todos os usuários. A LGPD limita o tratamento ao mínimo necessário (art. 6º, III), e a maior parte das investigações se resolve com metadados: versão do modelo e do prompt, tokens, erros e ferramentas chamadas. Quando o texto for necessário, capture por exceção, com mascaramento, acesso restrito e expiração curta.
Por quanto tempo devo manter logs de IA?
A LGPD não fixa um prazo único. Cada tipo de log deve ter prazo ligado à sua finalidade: métricas agregadas podem durar mais, logs técnicos sem conteúdo costumam ficar semanas ou poucos meses e amostras de prompts e respostas, poucos dias. Algumas obrigações têm prazo próprio, como os seis meses do Marco Civil para registros de acesso a aplicações. Portanto, documente cada prazo e automatize a expiração.
Mascarar os logs elimina o risco?
Não, mas reduz bastante. Detectores automáticos acertam padrões como CPF, e-mail e cartão, mas deixam passar nomes, endereços e relatos em texto livre. Por isso mascare na origem, teste com exemplos reais e combine com minimização, acesso restrito e prazo curto. Dado pseudonimizado de forma reversível continua sendo dado pessoal para a LGPD.
O titular pode pedir acesso ou eliminação de dados que estão nos logs?
Sim. Se os logs guardam informações que identificam a pessoa, valem os direitos do titular previstos no art. 18 da LGPD, como confirmação, acesso e, quando cabível, eliminação. Logs com identificadores pseudonimizados e prazos curtos simplificam esse atendimento, porque reduzem o que precisa ser localizado. Ter um mapa de onde cada tipo de log é armazenado também acelera a resposta.
O que registrar para investigar uma resposta errada da IA?
Registre o ID da requisição, o modelo e a versão usados, a versão do prompt de sistema, os parâmetros de geração, os IDs dos documentos recuperados, as ferramentas acionadas e seus status, o motivo de parada e as decisões dos filtros de segurança. Assim, a equipe reproduz o cenário em ambiente de teste, com dados sintéticos, sem depender do texto original do usuário.