Por Isabella Lapa | Atualizado em novembro de 2026
Resposta rápida: segurança em RAG é garantir que a busca da IA só recupere trechos que a pessoa que fez a pergunta tem permissão para ver. Isso exige permissões gravadas em cada documento e fragmento, identidade do usuário vinda da sessão autenticada, filtro aplicado antes da busca na base vetorial e isolamento entre clientes. O modelo de linguagem nunca deve ser quem decide a autorização.
Um analista comercial pergunta ao assistente interno da empresa qual foi o reajuste aprovado para a diretoria. A pergunta é inocente, e o sistema funciona exatamente como foi projetado: busca os trechos mais parecidos com a pergunta, encontra a ata do conselho que alguém indexou junto com o resto do repositório e entrega um resumo bem escrito. Não houve invasão, apenas uma busca que não verificou quem estava pedindo nem se essa pessoa tinha autorização para acessar o conteúdo.
Esse é o centro da segurança em RAG (Retrieval-Augmented Generation, a técnica que conecta um modelo de linguagem aos documentos da própria empresa). A seguir, você vai ver onde o vazamento acontece no pipeline, como aplicar permissões por documento e por fragmento, como levar a identidade do usuário até a consulta, como isolar clientes em aplicações multi-tenant e como testar tudo isso antes de ir para produção.
Encontrar um documento não é ter autorização para usá-lo
A busca de um RAG responde a uma pergunta: quais trechos são mais parecidos com o que o usuário escreveu? Ela não responde à pergunta que importa para a segurança: se esse usuário pode ver esses trechos. Similaridade e autorização são testes diferentes, e o controle de acesso em RAG existe para garantir que o segundo aconteça antes de qualquer conteúdo chegar ao modelo.
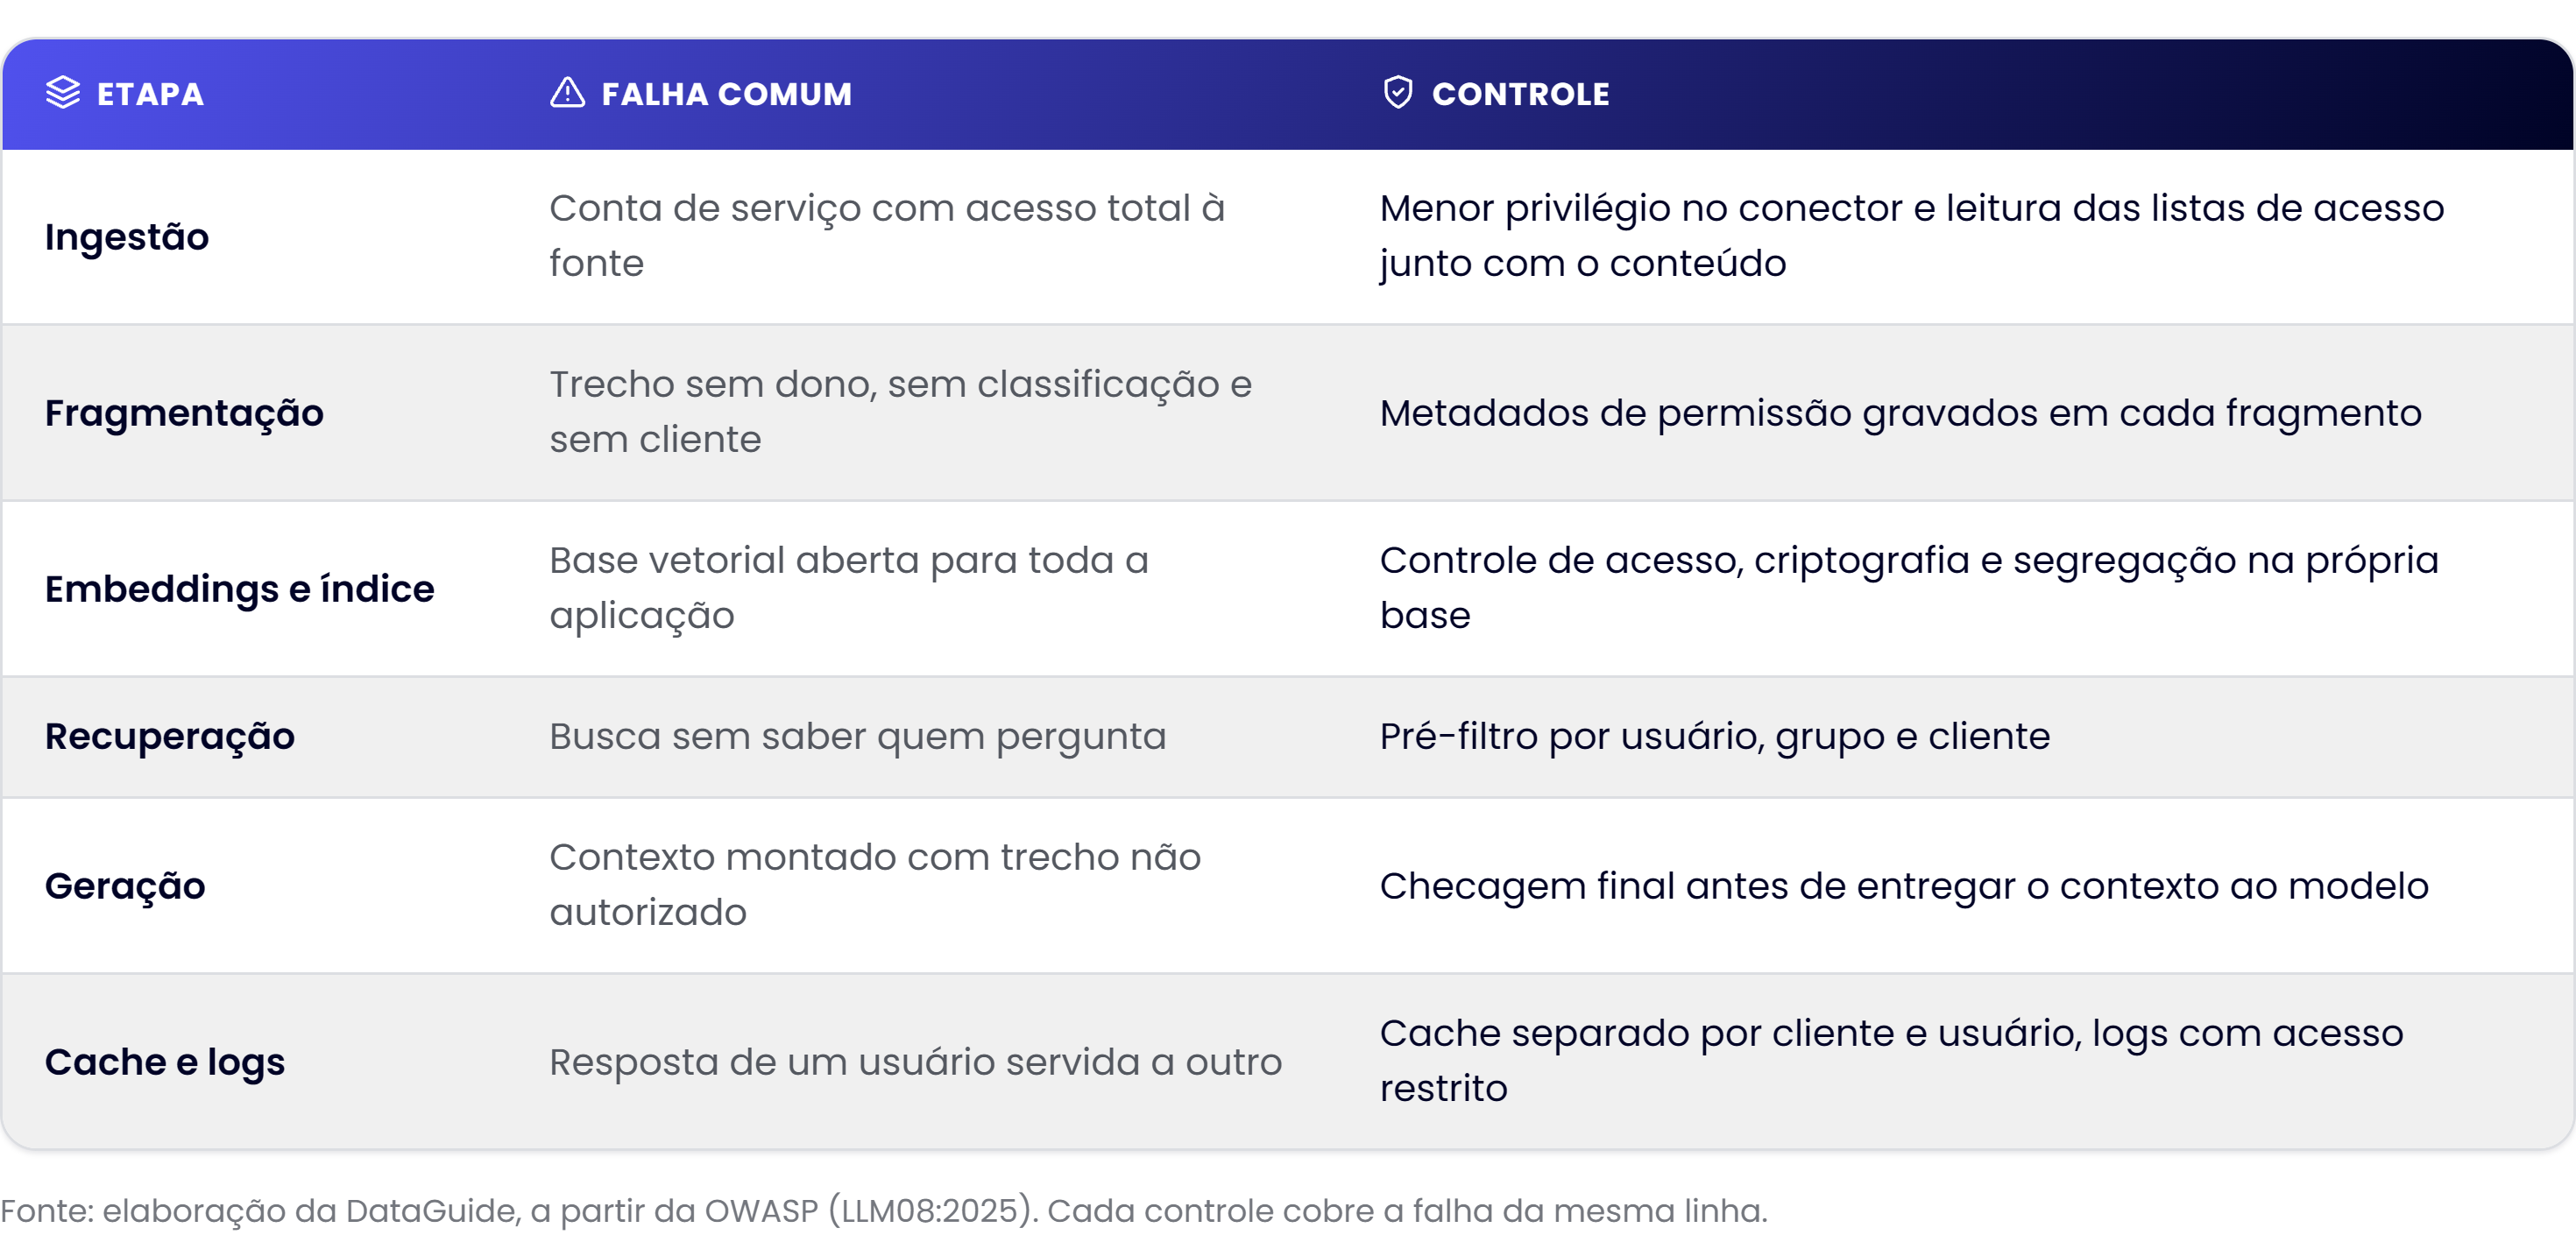
Em muitos projetos, o índice é montado por uma conta de serviço que enxerga tudo. Contratos, atas, planilhas de RH e chamados de suporte vão para a mesma base vetorial, sem registro de quem podia ler cada arquivo na origem. A partir daí, qualquer pergunta bem formulada pode trazer qualquer trecho.
A Microsoft, ao orientar a implantação do Copilot, resume o princípio correto: o assistente só exibe dados aos quais o usuário tem ao menos permissão de visualização. E alerta para o efeito colateral: se as permissões na origem estão abertas demais, a IA passa a encontrar com facilidade o que antes ficava esquecido numa pasta compartilhada.
O tema também é proteção de dados. Se o trecho recuperado contém dados pessoais, a exposição a quem não deveria vê-lo pode configurar incidente de segurança, ponto que se conecta ao que explicamos sobre inteligência artificial e LGPD.
Os números mostram que o risco já chegou às empresas. No relatório de 2025 da IBM, conduzido pelo Ponemon Institute com 600 organizações, 13% relataram violações em modelos ou aplicações de IA. Entre elas, 97% não tinham controles de acesso adequados para IA, e 60% dos incidentes resultaram em comprometimento de dados.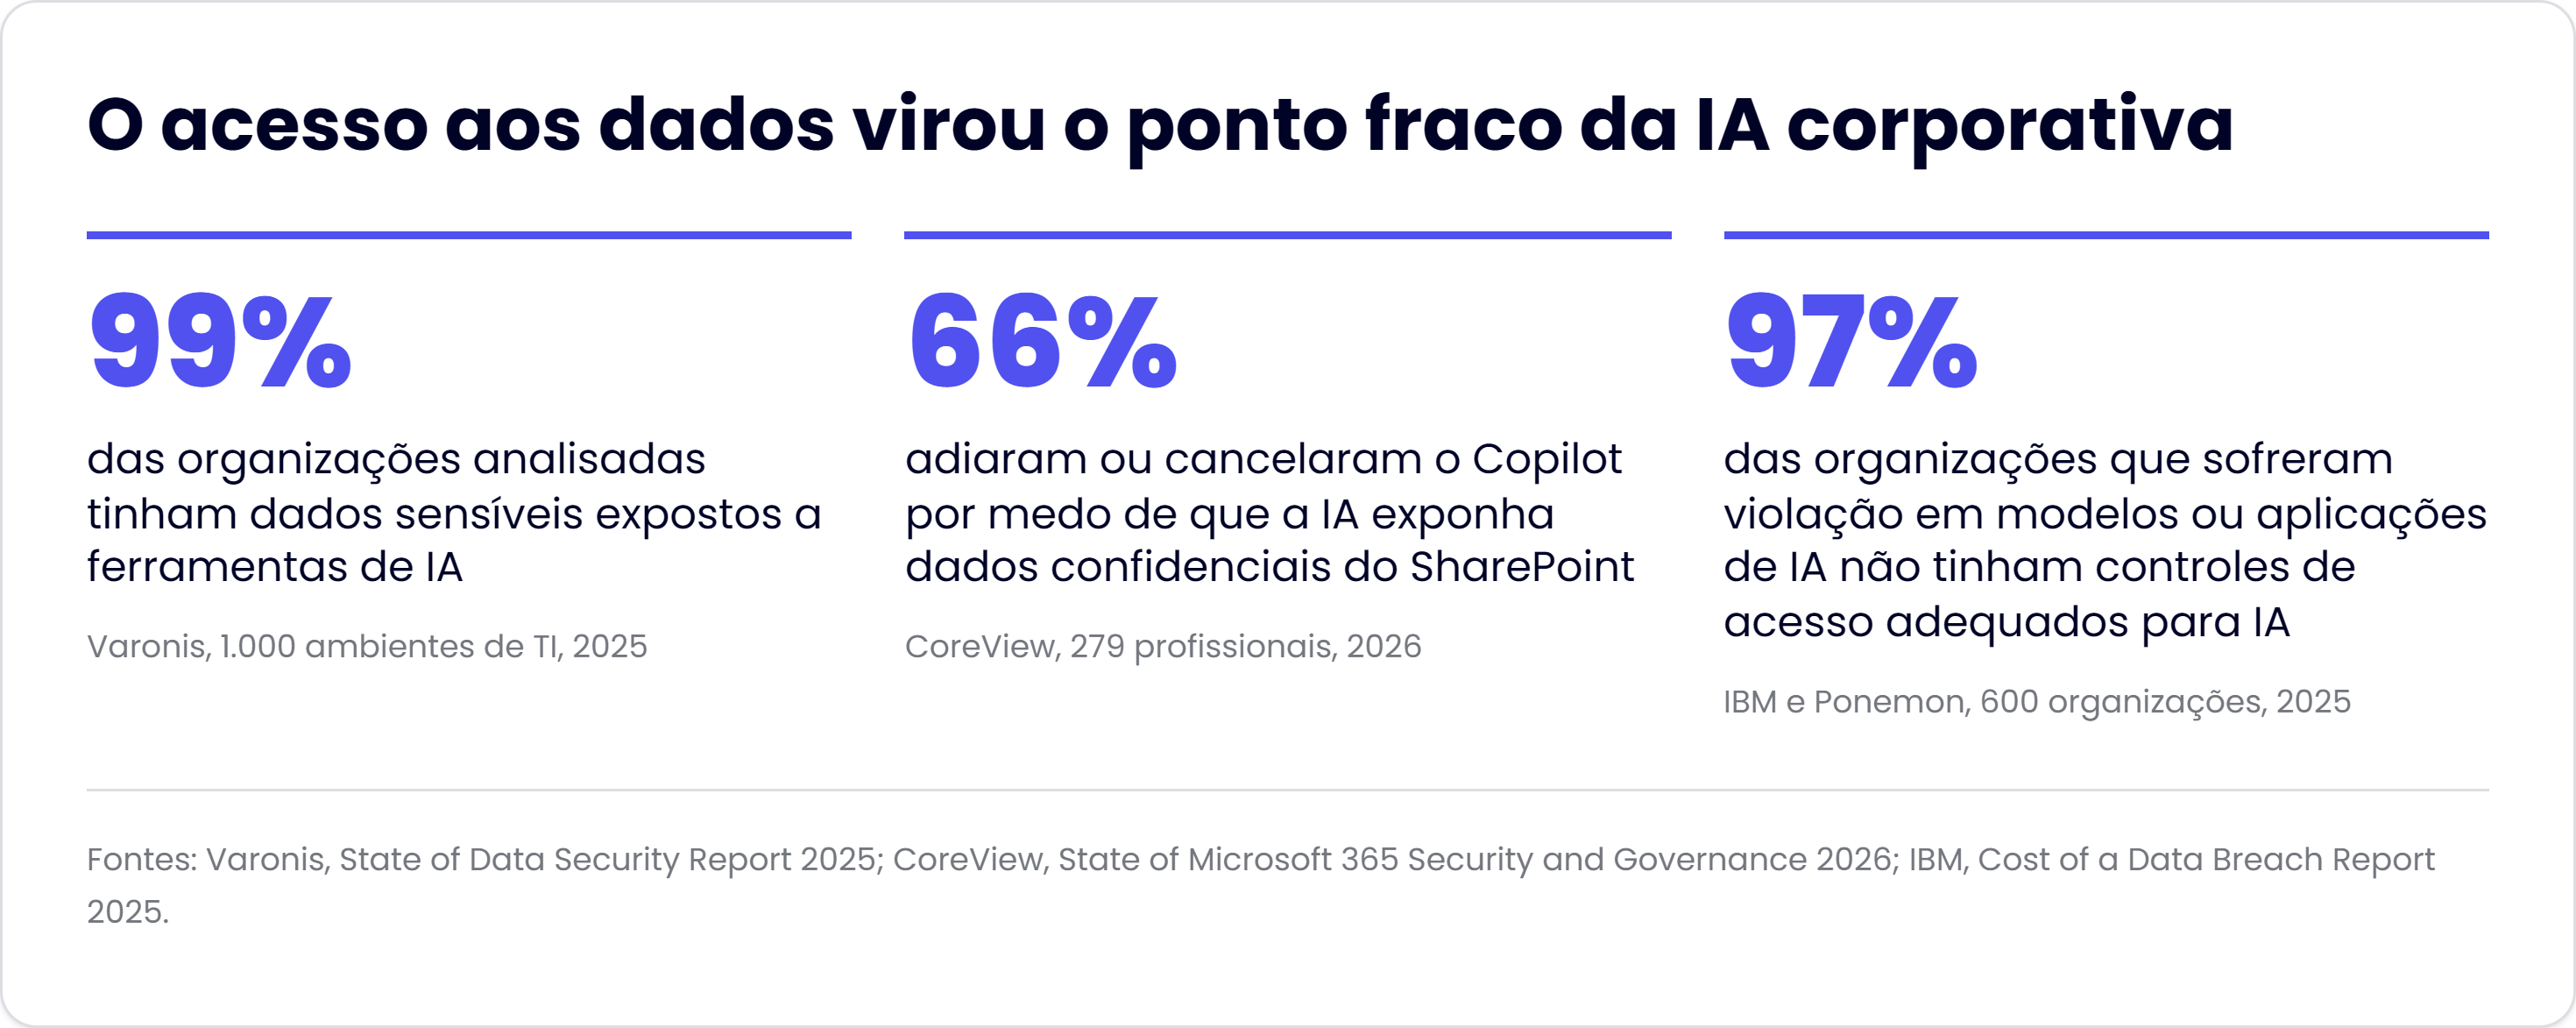
Figura 1. Três pesquisas recentes mostram que permissões mal resolvidas são o principal obstáculo para usar IA sobre documentos internos com segurança.
Texto alternativo: Três cartões com dados sobre segurança em RAG e acesso a dados por IA: 99% das organizações com dados sensíveis expostos a ferramentas de IA (Varonis, 2025); 66% adiaram ou cancelaram o Copilot por medo de exposição de dados do SharePoint (CoreView, 2026); 97% das organizações com violação em IA sem controles de acesso adequados (IBM, 2025).
Onde o vazamento acontece em um pipeline de RAG
Vazamento de dados por IA em um sistema RAG raramente acontece num único ponto. Ele aparece em qualquer etapa em que o pipeline perde a informação de quem pode ver o quê. A OWASP reconheceu o problema no Top 10 para aplicações com LLM de 2025, na categoria LLM08 (fraquezas em vetores e embeddings), que cita acesso não autorizado, vazamento entre contextos em ambientes multi-tenant e inversão de embeddings.
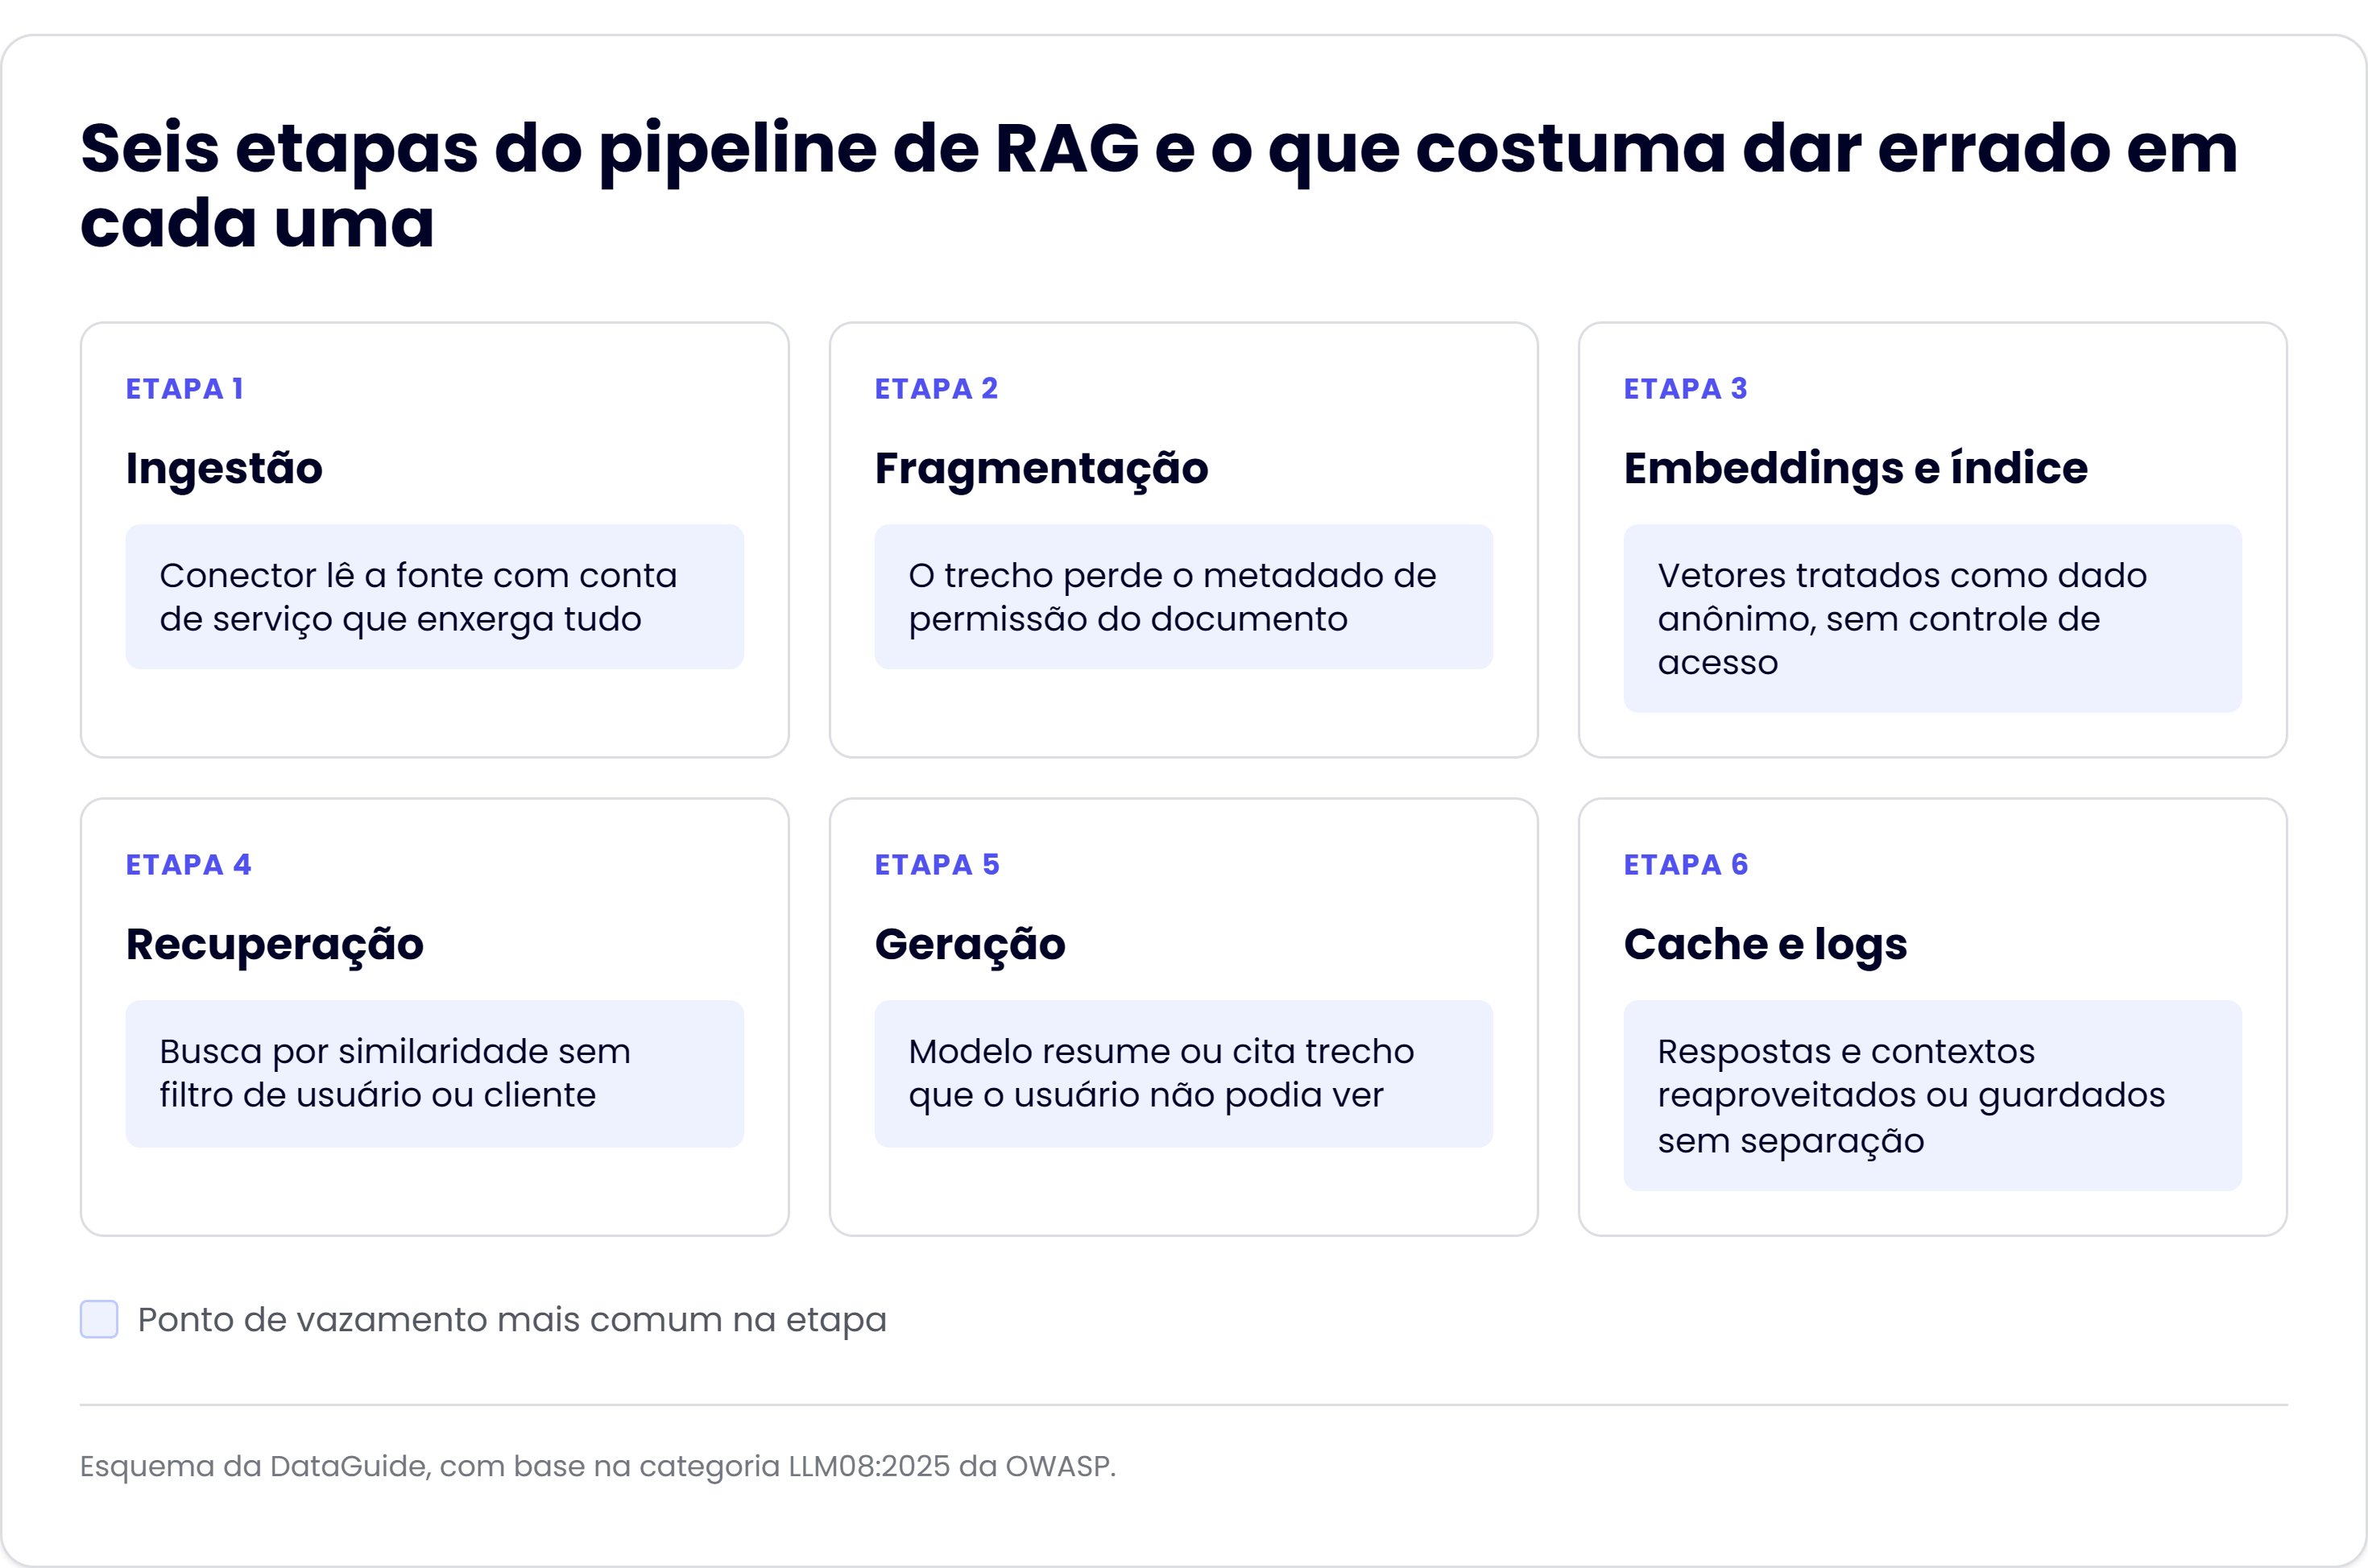
Figura 2. O vazamento em RAG acontece onde o pipeline deixa de carregar a informação de quem pode acessar cada trecho.
Texto alternativo: Diagrama do pipeline de segurança em RAG com seis etapas: ingestão, fragmentação, embeddings e índice, recuperação, geração e cache e logs. Cada etapa traz em destaque a falha mais comum, como conta de serviço com acesso total, trecho sem metadado de permissão e busca sem filtro de usuário.
Um ponto que costuma surpreender é que o vetor não é uma versão anonimizada do texto. Pesquisadores da Universidade Cornell mostraram, em 2023, que um método de inversão recuperou exatamente 92% de textos curtos, de 32 tokens, a partir dos embeddings. Por isso, a base vetorial precisa do mesmo controle de acesso que o documento de origem.
Permissões por documento e por fragmento
Autorização por documento significa gravar, junto de cada trecho indexado, a lista de quem pode lê-lo, sejam usuários, grupos, área, nível de classificação e cliente. Sem esse metadado no fragmento, não existe filtro possível na hora da busca.
O fragmento herda as permissões do documento de onde saiu. Assim, quando um arquivo mistura partes com sensibilidades diferentes (um contrato com anexo de remuneração, por exemplo), a saída mais segura é aplicar ao trecho a permissão mais restritiva da seção a que ele pertence, ou separar o anexo como documento próprio antes de indexar.
A mesma lógica vale para tudo o que é derivado, como resumos gerados automaticamente, perguntas sintéticas e metadados enriquecidos herdam a permissão mais restritiva entre as fontes que os originaram. Se em um resumo de três documentos, um deles confidencial, então todo o documento se torna confidencial.
Herdar permissões da fonte original
As permissões em base vetorial não devem ser inventadas pelo projeto de IA, elasprecisam vir da fonte: SharePoint, Google Drive, Confluence, CRM ou sistema de chamados. O conector lê a lista de acesso junto com o conteúdo e a sincroniza sempre que algo muda.
São três as situações que costumam falhar:
A revogação: alguém sai do projeto, perde acesso à pasta, mas continua vendo os trechos no índice até a próxima sincronização.
A exclusão: o documento é apagado na origem, inclusive por pedido de eliminação de um titular, e o vetor permanece.
Grupos: a permissão é dada a um grupo cuja composição muda sem que o índice fique sabendo.
Herdar permissões também herda os erros. Logo, se a pasta está compartilhada com a empresa inteira, o RAG vai respeitar isso. A pesquisa da CoreView ilustra o tamanho da preocupação: 73% dos profissionais de Microsoft 365 temem que a IA já esteja expondo informações sensíveis internamente. Por isso a revisão de compartilhamento na origem vem antes da indexação.
Identidade do usuário e filtros aplicados na consulta
O controle de acesso em RAG depende de saber, com certeza, quem está perguntando. Essa identidade precisa vir da sessão autenticada da aplicação (o token de login), e não de algo escrito no prompt. Se o sistema aceita "sou da diretoria" como informação de identidade, qualquer usuário consegue se promover.
Com a identidade resolvida, inclusive os grupos a que a pessoa pertence, o filtro entra na própria consulta à base vetorial: a busca só considera fragmentos cujos metadados autorizam aquele usuário, grupo e cliente. É o pré-filtro.
Outra armadilha é a credencial da própria aplicação. Quando a busca roda com uma conta que enxerga todo o índice e depende só do filtro montado pelo código, um erro nesse filtro vira vazamento. Quanto mais a própria base vetorial conseguir impor a permissão, menor o estrago de um bug.
Buscar primeiro e filtrar depois parece equivalente, mas traz dois problemas. O conteúdo não autorizado já circulou pelo sistema e pode parar em cache ou log. E, se os dez trechos mais parecidos forem todos proibidos, o usuário recebe uma resposta vazia, o que costuma levar a equipe a afrouxar a regra.
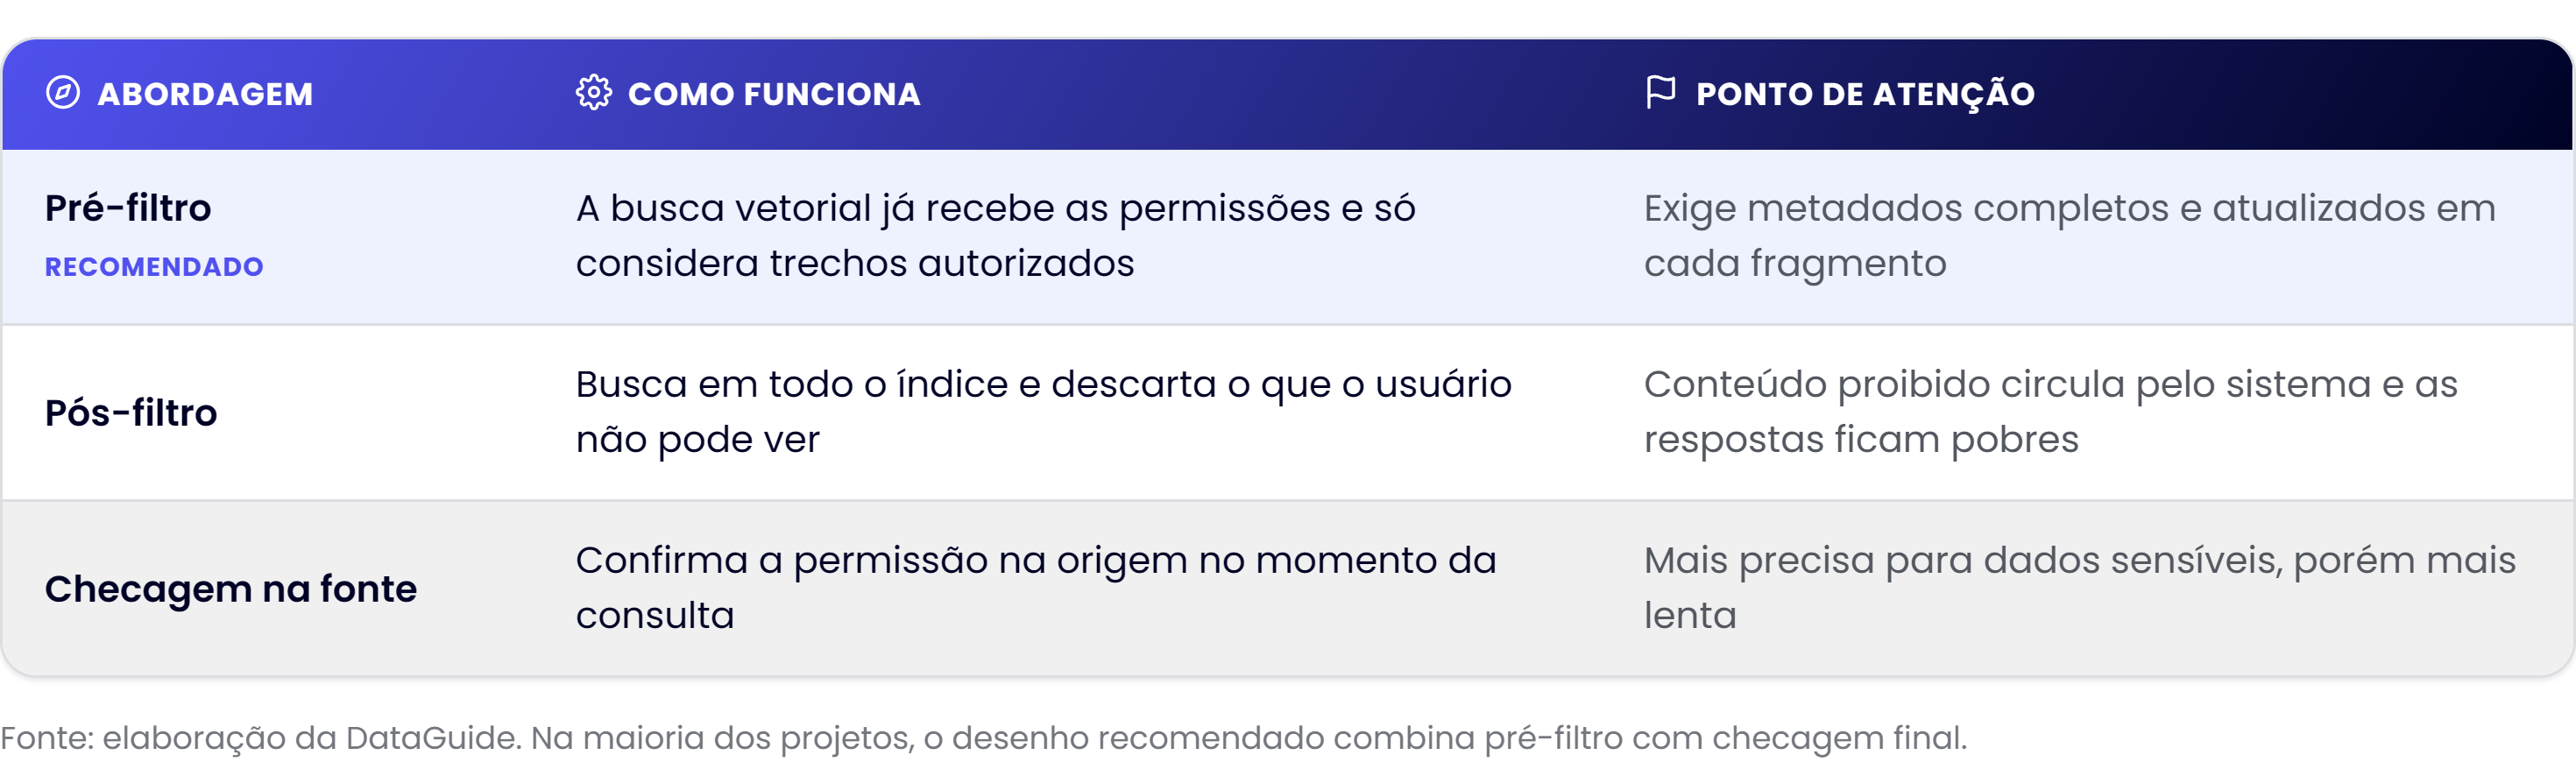
Duas regras fecham o desenho. Uma checagem final, antes de montar o contexto, confirma a permissão de cada trecho. E o modelo de linguagem nunca decide autorização: instruções como "não mostre dados confidenciais" no prompt não são controle de acesso, porque podem ser contornadas, inclusive por prompt injection. A regra precisa estar no código que busca, e não no texto que o modelo lê.
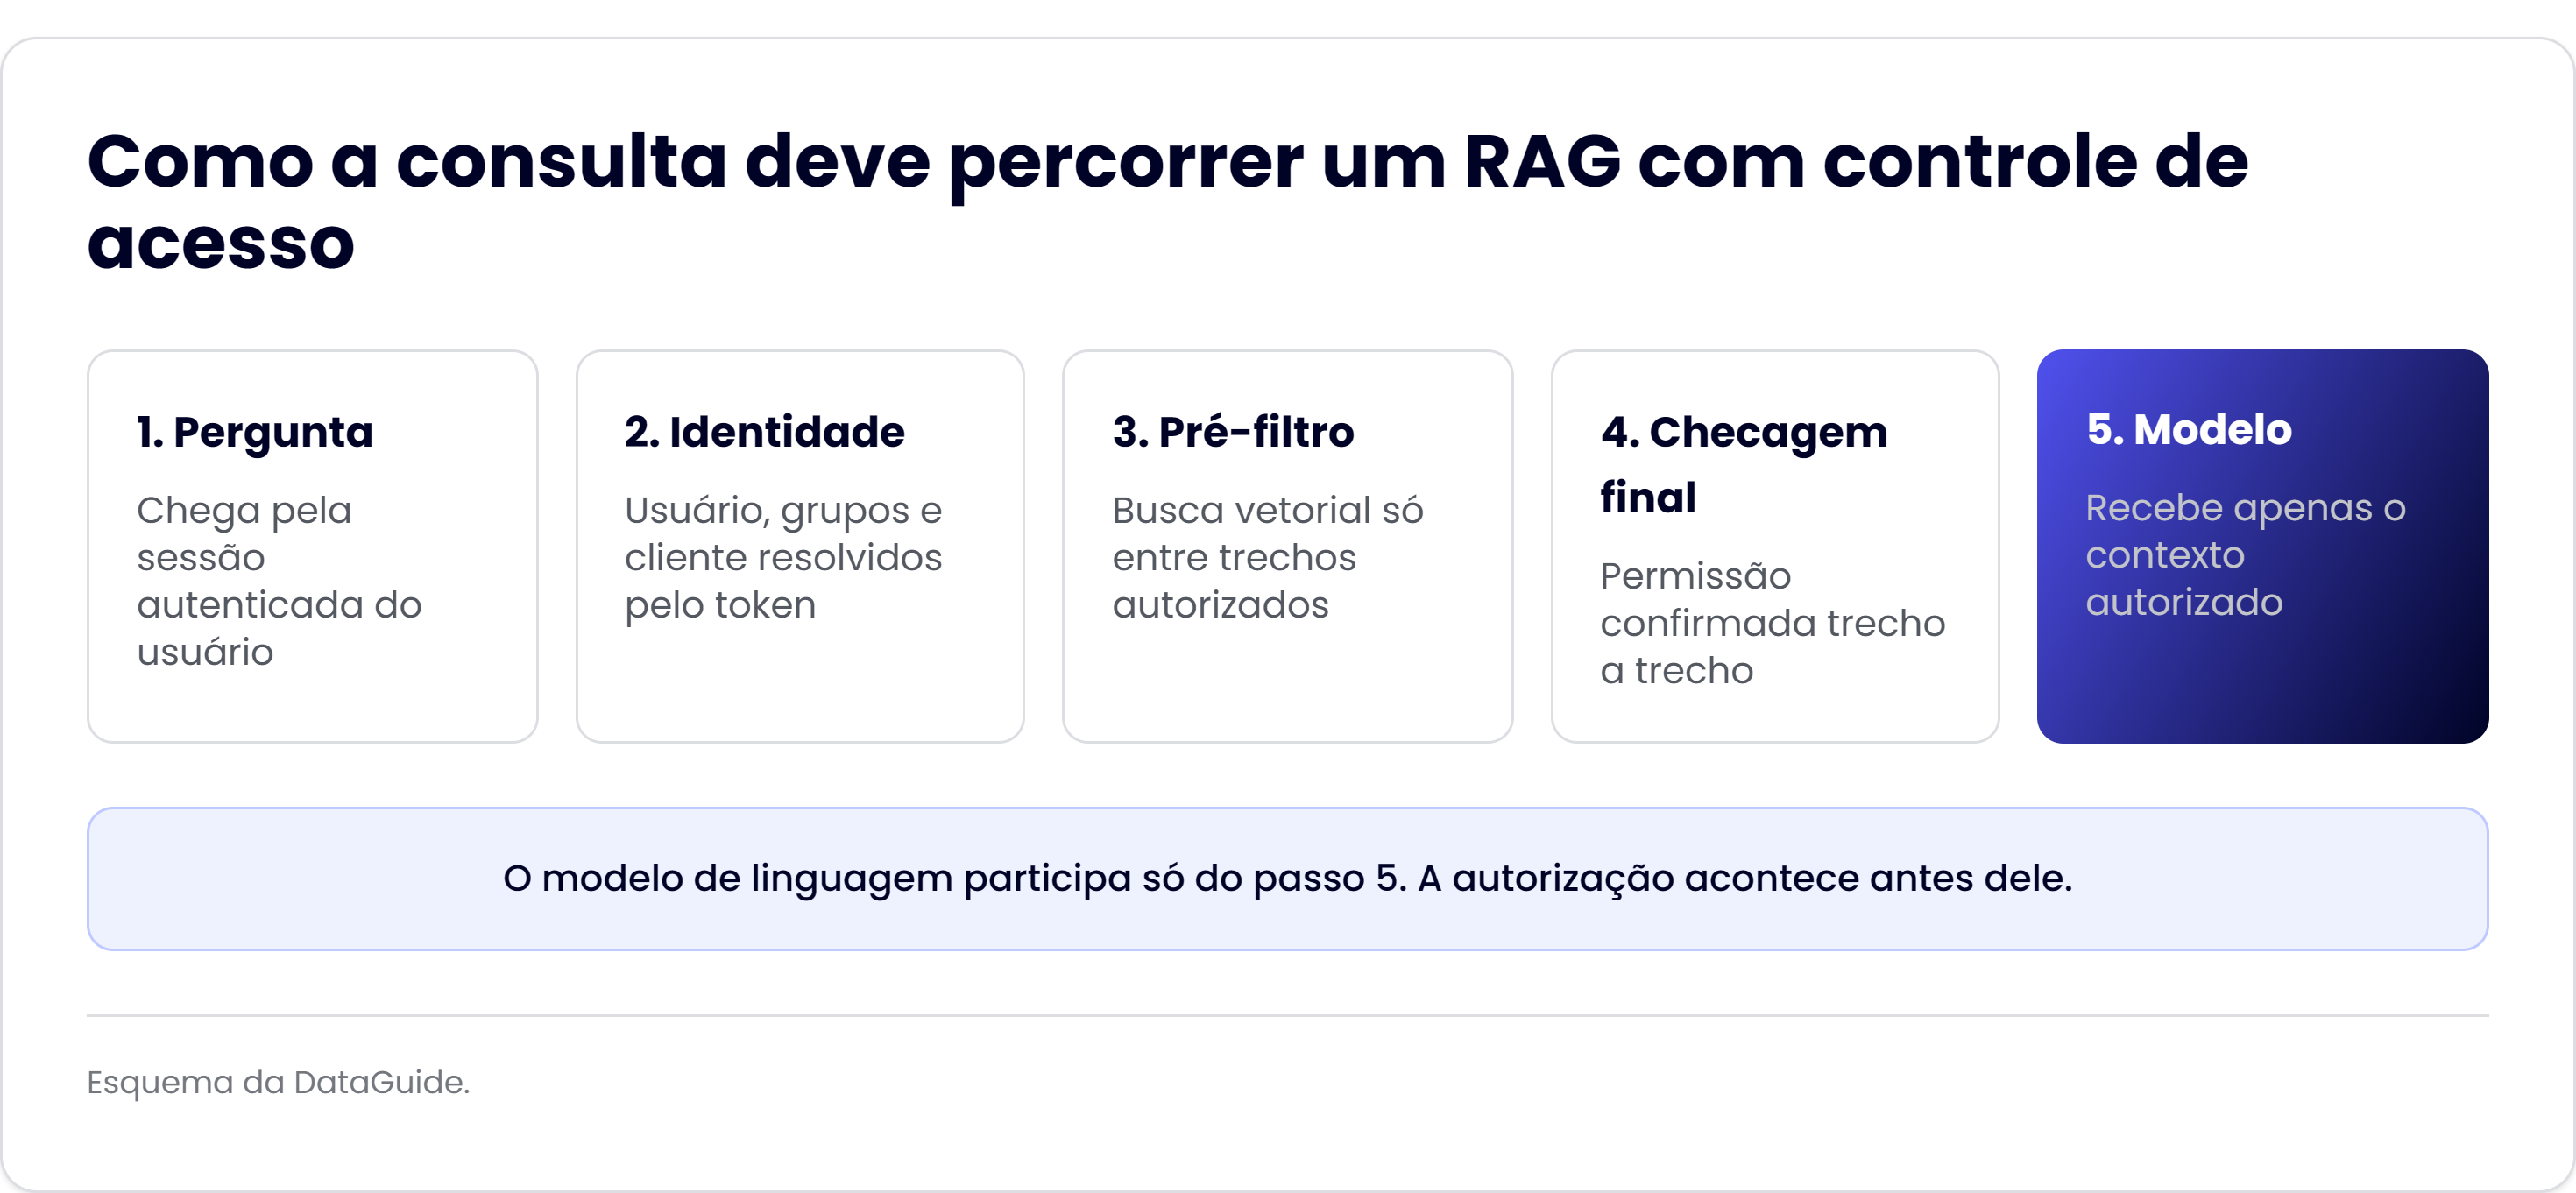
Figura 3. Os cinco passos de uma consulta com controle de acesso em RAG, do login ao contexto entregue ao modelo.
Texto alternativo: Fluxo de controle de acesso em RAG em cinco passos: pergunta pela sessão autenticada, identidade e grupos resolvidos pelo token, busca vetorial com pré-filtro, checagem final de permissão e modelo de linguagem recebendo apenas o contexto autorizado.
Isolamento entre clientes em aplicações multi-tenant
Em um RAG multi-tenant, a mesma plataforma atende várias empresas clientes. Nesse cenário, o vazamento muda de escala: em vez de um funcionário lendo a ata da diretoria, é um cliente lendo o documento de outro. A OWASP descreve esse cenário na categoria LLM08: embeddings de um grupo recuperados por engano nas respostas de outro, num banco vetorial compartilhado.
Há três padrões de isolamento, com custos e riscos diferentes.
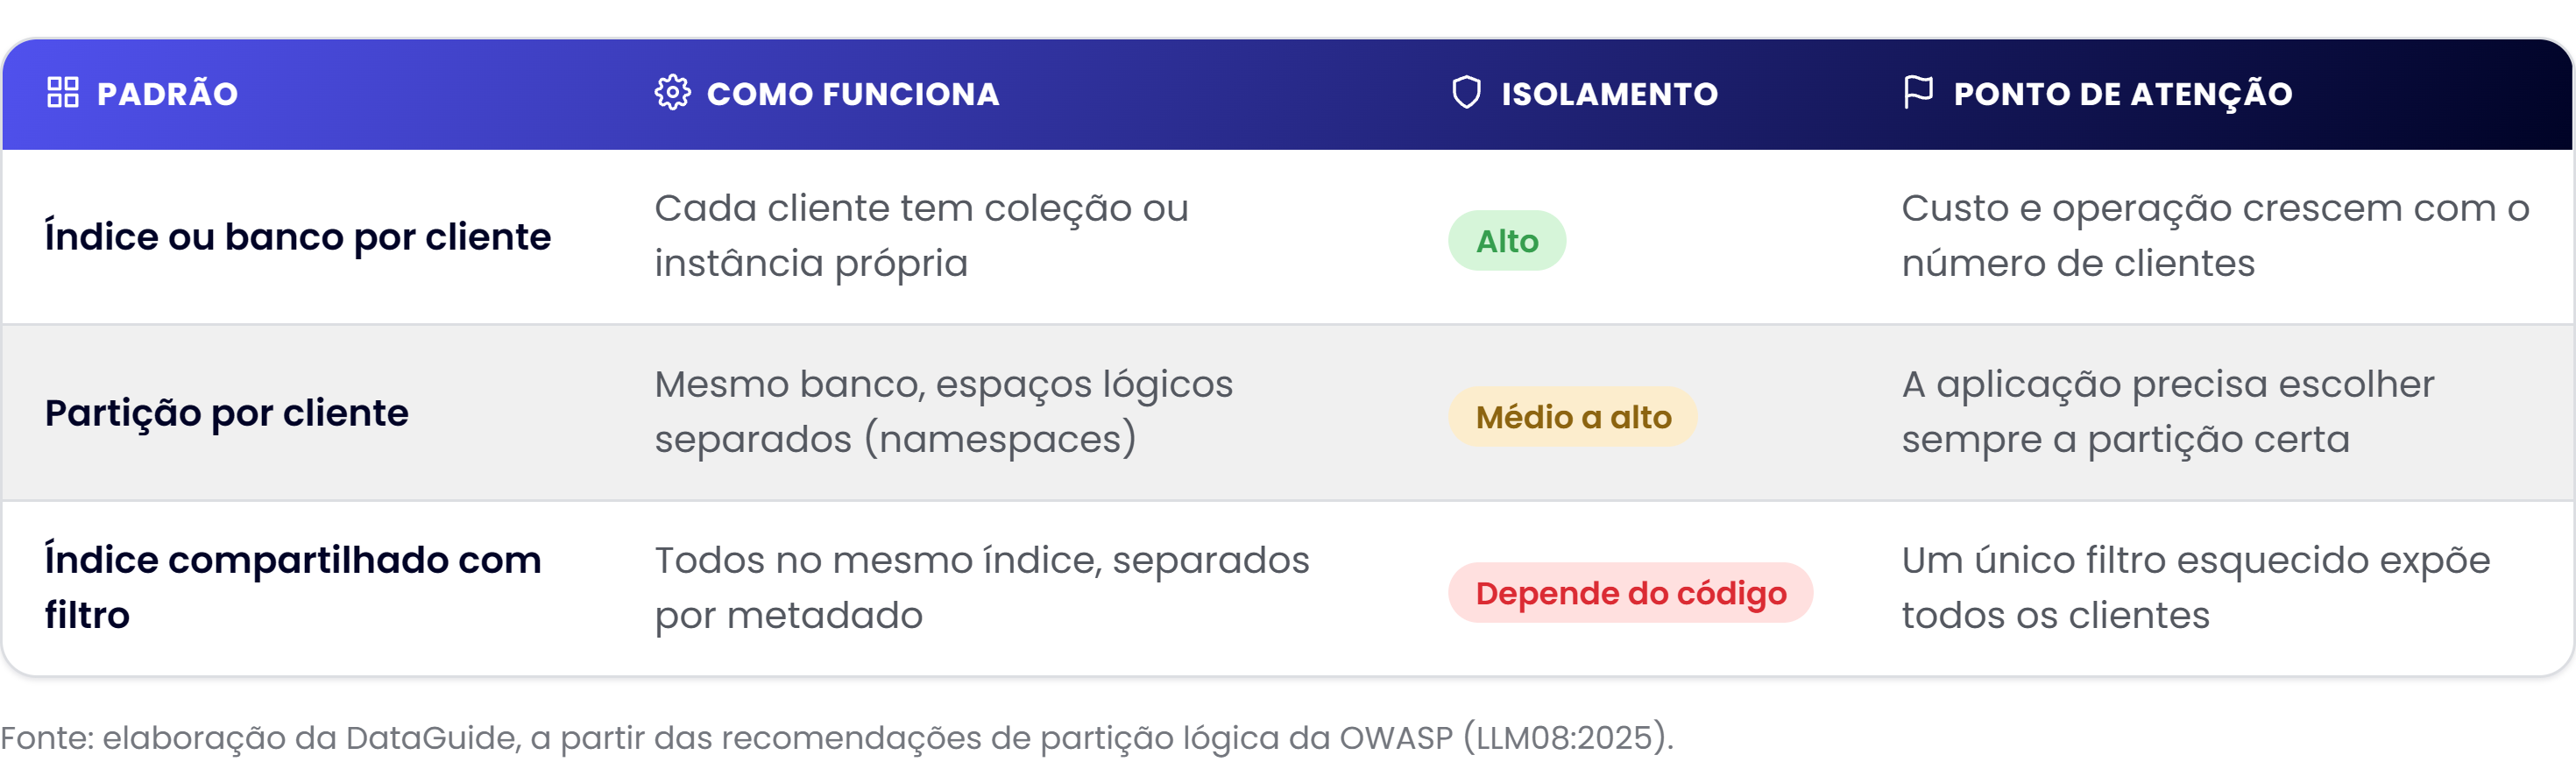 Em qualquer padrão, o identificador do cliente deve vir da sessão, nunca de um parâmetro que o usuário consiga alterar. O cache de buscas e de respostas precisa ser separado por cliente e por usuário, e chaves de criptografia por cliente reduzem o impacto se algo falhar. Para clientes com dados de saúde ou financeiros, o índice dedicado costuma compensar o custo.
Como testar se o isolamento funciona
Isolamento de dados em IA não se comprova com a arquitetura no papel, porém comprova-se com teste, e o método mais útil é o dos documentos sentinela: arquivos sintéticos, cada um com um marcador único (um código inventado), colocados em cada nível de permissão e em cada cliente de teste.
Depois, personas de teste com perfis diferentes fazem perguntas que deveriam encontrar esses marcadores. O resultado esperado é simples: cada persona só vê o marcador do seu nível. Se o código de outro cliente aparecer na resposta, na citação ou no log, o isolamento falhou.
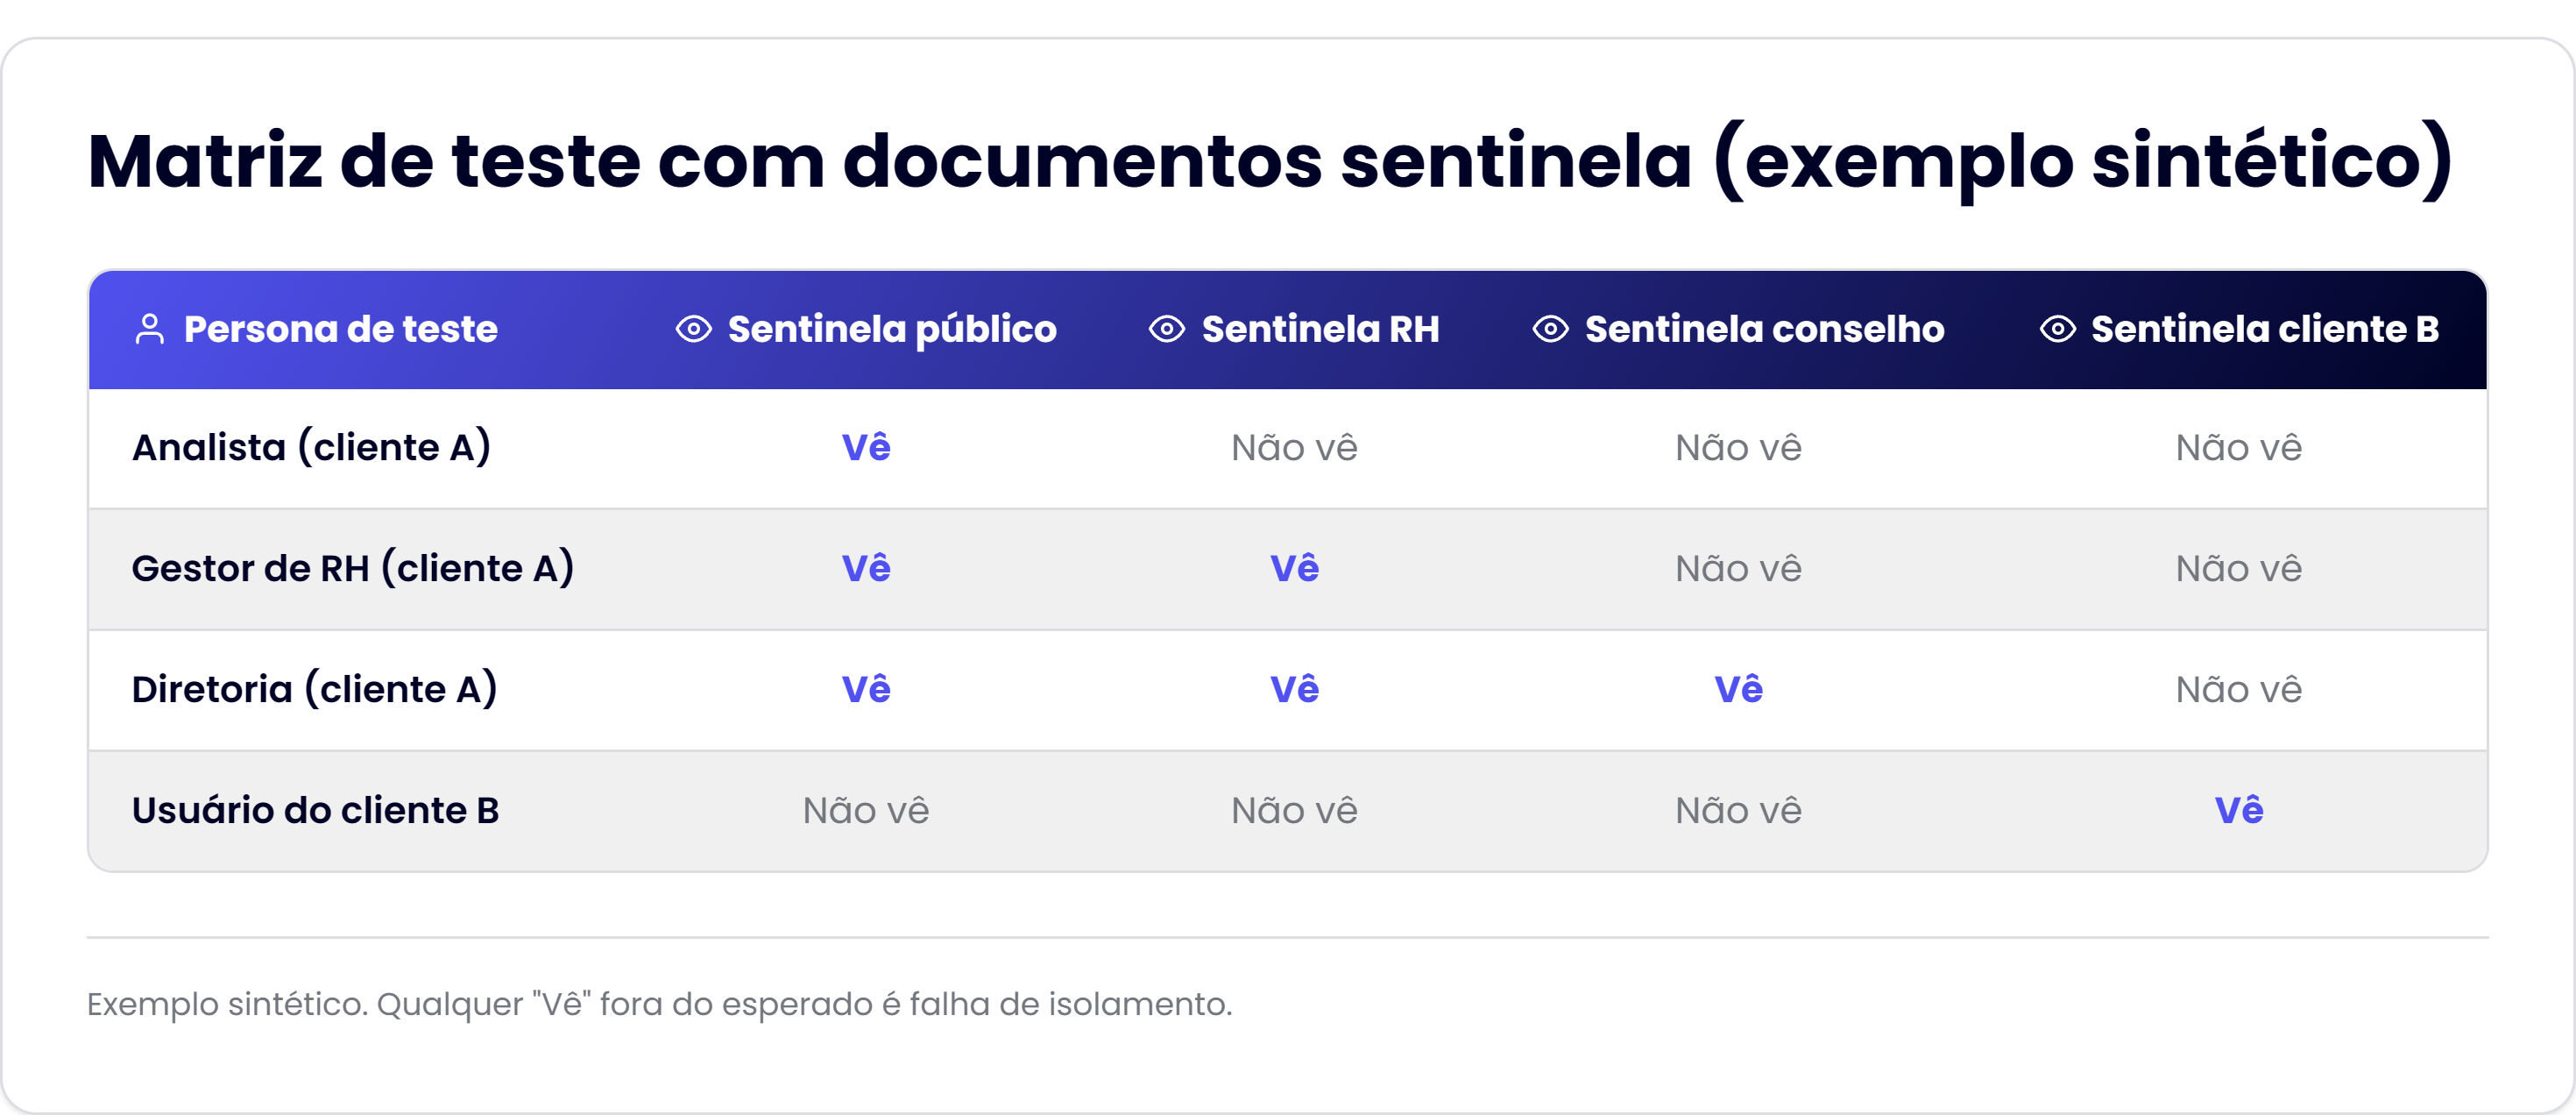
Figura 4. A matriz cruza personas e documentos sentinela e define, antes do teste, o que cada perfil pode ou não recuperar.
Texto alternativo: Tabela de teste de isolamento de dados em RAG com quatro personas (analista, gestor de RH e diretoria do cliente A e um usuário do cliente B) e quatro documentos sentinela (público, RH, conselho e cliente B), indicando em cada célula se a persona deve ver ou não o marcador.
Vale incluir no roteiro:
revogação: tirar o acesso de uma persona e medir em quanto tempo o índice reflete a mudança;
exclusão: apagar o documento na origem e confirmar que o trecho some da busca;
citações e cache: conferir se títulos e trechos de fontes proibidas aparecem nas referências ou em respostas reaproveitadas;
regressão: rodar os testes a cada mudança no conector, no índice ou no modelo.
Esses testes internos não substituem uma avaliação externa. Um pentest focado em autorização olha a aplicação como um atacante olharia, incluindo APIs e parâmetros de cliente, como detalhamos no guia de pentest em empresas SaaS.
Checklist antes de colocar o RAG em produção
Antes de liberar o assistente para usuários reais, confirme os itens abaixo. Juntos, eles formam a base da segurança em RAG.
Checklist de segurança em RAG
1. Compartilhamentos amplos revisados na origem antes da indexação.
2. Conector com o menor privilégio necessário, sem conta de serviço com acesso total.
3. Cada fragmento com metadados de permissão, classificação e cliente.
4. Revogações e exclusões sincronizadas com prazo definido.
5. Identidade do usuário vinda da sessão autenticada.
6. Pré-filtro de permissão aplicado na consulta à base vetorial.
7. Checagem final antes de montar o contexto do modelo.
8. Isolamento entre clientes definido e testado, com cache separado.
9. Base vetorial, logs e cache protegidos como o dado de origem.
10. Testes com documentos sentinela rodando a cada entrega.
Na prática: se uma regra de acesso só existe no prompt, ela não existe. Autorização é a decisão do código que busca, tomada antes de o modelo ler qualquer trecho.
Conclusão
A busca da IA vai encontrar o documento certo. A pergunta que define a segurança em RAG é outra: quem estava pedindo podia vê-lo? Permissões gravadas no fragmento, identidade vinda da sessão, filtro aplicado antes da busca, isolamento entre clientes e testes com documentos sentinela respondem a essa pergunta antes que um usuário descubra a resposta por conta própria.
Esses controles também fazem parte de uma gestão de IA auditável. A ISO 42001 pede controles sobre dados e ciclo de vida dos sistemas de IA, e o controle de acesso na recuperação é um dos primeiros que um auditor vai querer ver funcionando.
Avalie a arquitetura do seu RAG antes de ir para produção. A DataGuide revisa permissões, filtros, isolamento entre clientes e testes de autorização do seu pipeline, com pentest focado na aplicação. Conheça as nossas soluções de segurança da informação.
Fontes
OWASP: LLM08:2025, Vector and Embedding Weaknesses (OWASP Top 10 para aplicações com LLM)
Varonis: State of Data Security Report 2025: 99% das organizações com dados sensíveis expostos à IA
CoreView: 66% das empresas adiam o Microsoft Copilot por risco de exposição de dados
Microsoft: Boas práticas do SharePoint para o Copilot e o risco de compartilhamento excessivo
Cornell University: Text Embeddings Reveal (Almost) As Much As Text (2023)
Lei 13.709/2018 (LGPD): Lei Geral de Proteção de Dados, texto oficial no Planalto
Resolução CD/ANPD nº 15/2024: Machado Meyer: ANPD publica regulamento de comunicação de incidente de segurança